


java命名规范
-
entity 包
-
config: 作用: 存放与实体类相关的配置类,例如 JPA 实体监听器、自定义类型转换器等。 内容: 通常情况下,实体类相关的配置比较少,可以不创建 config 包,而是将配置类放在 entity 包下。
-
constants: 作用: 存放与实体类相关的常量,例如表名、字段名、错误信息等。 内容: 可以将所有实体类的常量都放在一个 Constants 类中,也可以根据实体类进行分组,每个实体类对应一个常量类。
-
dto (Data Transfer Object): 作用: 存放数据传输对象,用于在不同层之间传递数据。 内容: DTO 通常只包含数据,不包含业务逻辑。 可以根据不同的业务场景创建不同的 DTO 类,例如 UserCreateDTO、UserUpdateDTO、UserResponseDTO 等。
-
enums: 作用: 存放枚举类,用于定义实体类中字段的取值范围。 内容: 将枚举类放在 enums 包下可以使代码结构更加清晰。
-
po (Persistent Object): 作用: 存放持久化对象,与数据库表结构一一对应。 内容: PO 通常只包含属性和 getter/setter 方法,不包含业务逻辑。 在使用 JPA 的情况下,PO 类上需要使用 @Entity 注解。 有些开发者会将 entity 包直接作为 po 包使用,不再区分 entity 和 po。
-
query: 作用: 存放查询对象,用于封装复杂的查询条件。 内容: 当查询条件比较简单时,可以直接在 Repository 接口中定义查询方法。 当查询条件比较复杂时,可以将查询条件封装成一个 query 对象,方便传递参数和复用查询逻辑。
-
vo (Value Object): 作用: 存放值对象,用于封装返回给前端的数据。 内容: VO 通常只包含数据,不包含业务逻辑。 可以根据不同的接口返回不同的 VO 类。
-
-
utils 包
作用: 存放工具类,提供通用的功能方法。 内容: 工具类通常是无状态的,包含静态方法,方便其他类调用。 可以包含字符串处理、日期时间格式化、文件操作、网络请求等各种具类。
-
component 包: 作用: 存放 Spring 组件类,例如 Service 类、Repository 类、Configuration 类等。 内容: @Service: 业务逻辑层,处理业务逻辑,调用 Dao 层完成数据操作。 @Repository: 数据访问层,负责与数据库交互,执行数据操作。 @Component: 泛指组件,当一个类不适合归类到 @Service, @Repository 或 @Controller 时,可以使用 @Component 注解。 @Configuration: 配置类,用于配置 Spring Bean。
IDEA常用快捷键
ctrl+shift+u 大小写转换
ctrl+alt+点击 转到实现处
Ctrl + W 选中代码,连续按还会选中更多
Ctrl + Alt + L 格式化代码
Ctrl + H 显示类结构图
Ctrl + I 实现方法
springboot常用注解
1.注册bean对象注解
@Component: 通用的组件注解,可以用于标记任何需要被 Spring 管理的类。 @Service: 用于标记业务逻辑层组件,通常包含业务逻辑处理代码。 @Repository: 用于标记数据访问层组件,通常用于与数据库交互。 @Controller: 用于标记 Web 层控制器组件,通常用于处理 HTTP 请求。
2.扫描bean对象注解
@MapperScan MyBatis 框架提供的一个注解,==用于扫描指定包下的所有 Mapper 接口==,并将这些接口注册为 Spring 管理的 Bean。
@ComponentScan 是 Spring 框架提供的一个注解,用于==指定 Spring 应该扫描哪些包以查找并注册带有特定注解的类为 Spring 管理的 Bean==。这些特定注解包括但不限于 @Component、@Service、@Repository 和 @Controller。
@SpringBootApplication 默认扫描当前包及其子包 ,是 Spring Boot 提供的一个复合注解,它实际上是以下三个注解的组合:
@Configuration:表示该类是一个配置类,可以用来定义 Bean。@EnableAutoConfiguration:启用 Spring Boot 的自动配置功能,根据添加的 jar 依赖自动配置 Spring 应用。@ComponentScan:启用组件扫描,自动发现和注册 Spring 管理的 Bean。
综合使用示例
假设你有一个 Spring Boot 应用,需要从 com.ruoyi.math.mappers 包中扫描并注册所有 MyBatis 的 Mapper 接口,从 com.ruoyi 包中扫描所有 Spring 组件,并且还需要额外从 com.example.service 和 com.example.repository 包中扫描更多的 Spring 组件。可以这样做:
import org.mybatis.spring.annotation.MapperScan;import org.springframework.boot.SpringApplication;import org.springframework.boot.autoconfigure.SpringBootApplication;import org.springframework.context.annotation.ComponentScan;
@SpringBootApplication(scanBasePackages = {"com.ruoyi"})@MapperScan(basePackages = {"com.ruoyi.math.mappers"})@ComponentScan({"com.example.service", "com.example.repository"})public class Application { public static void main(String[] args) { SpringApplication.run(Application.class, args); }}-
@SpringBootApplication(scanBasePackages = {"com.ruoyi"}):- 启用了 Spring Boot 的自动配置功能。
- 从
com.ruoyi包及其子包中扫描并注册所有 Spring 组件。
-
@MapperScan(basePackages = {"com.ruoyi.math.mappers"}):- 从
com.ruoyi.math.mappers包中扫描并注册所有 MyBatis 的 Mapper 接口。
- 从
-
@ComponentScan({"com.example.service", "com.example.repository"}):- 从
com.example.service和com.example.repository包中扫描并注册所有 Spring 组件。
- 从
-
重复扫描:如果
@SpringBootApplication和@ComponentScan指定的包路径有重叠,可能会导致某些组件被多次扫描。通常情况下,@SpringBootApplication已经足够,不需要额外使==用 ====@ComponentScan====,除非你需要扫描额外的包==。 -
默认行为:如果没有显式指定
@ComponentScan,@SpringBootApplication默认会从当前类所在的包及其子包开始扫描。
3.@Value注解
@Value 注解用于将属性值注入到 bean 的属性、构造函数参数或方法参数中。
它可以读取和注入来自各种来源的配置属性值
例如: properties 文件 @Value(”${spring.mail.username:}”) YAML 文件 环境变量 系统属性
2024/11/15
1.maven项目pom.xml文件
用于管理项目的依赖、构建过程和其他配置,实质上是对jar包的管理
-
(1)项目信息
-
==<groupId>==com.MiKouPan_workspace</groupId>: 项目的组 ID,通常是公司或组织的域名反写。
-
==<artifactId>==MiKouPan_workspace</artifactId>: 项目的 Artifact ID,项目的唯一标识符。
-
==<version>==0.0.1-SNAPSHOT</version>: 项目的版本号。 SNAPSHOT 表示这是一个开发版本。
-
==上述三者共同构成maven的坐标,一起唯一确定一个 Maven 构件。==
-
<name>MiKouPan_workspace</name>: 项目的名称。
-
<description>MiKouPan_workspace</description>: 项目的描述
-
(2)父项目
-
<parent> 部分定义了项目的父项目,继承自 spring-boot-starter-parent。 这样可以继承 Spring Boot 的默认配置,简化项目的配置管理。
-
==父项目(parent project)本身也是一个 Maven 项目==,它通常位于 Maven 仓库中。 你在子项目的 pom.xml 文件中通过 <parent> 元素声明父项目的坐标,Maven 就会从仓库中下载父项目的 pom.xml 文件,并继承其配置。
-
(3)属性
-
<properties> 部分定义了一些项目属性,例如 Java 版本、编码、Spring Boot 版本、MyBatis ==版本==等。 这些属性可以在 pom.xml 文件的其他地方使用,例如在依赖的版本号中。 使用属性可以使版本管理更方便,避免重复。
-
**(4)依赖 **
<dependencies> 部分定义了项目的依赖项
-
常用的有:
-
spring-boot-starter-web: Spring Boot Web 启动器,包含了 Spring MVC、嵌入式 Tomcat 等 Web 开发所需的依赖。
-
spring-boot-starter-test: Spring Boot 测试启动器,包含了测试所需的依赖。
-
spring-boot-starter-mail: Spring Boot 邮件启动器,用于发送邮件。
-
spring-boot-starter-data-redis: Spring Boot Redis 启动器,用于集成 Redis。
-
mybatis-spring-boot-starter: MyBatis Spring Boot 启动器,用于集成 MyBatis。
-
mysql-connector-java: MySQL 数据库驱动。
-
logback-classic 和 logback-core: Logback 日志框架。
-
aspectjweaver: AspectJ 切面编程框架。
-
okhttp: OkHttp HTTP 客户端。
-
fastjson: Fastjson JSON 处理库。
-
commons-lang3, commons-codec, commons-io: Apache Commons 工具库。
-
<exclusion>排除依赖避免冲突
-
(5)构建
-
<build> 部分定义了项目的构建配置
-
<plugins>: 包含所有使用的插件的列表。
-
<executions>: 定义插件的执行配置。
-
<execution>: 定义一个具体的执行配置。
-
<goals>: 指定要执行的插件目标。
- <goal>repackage</goal>: 这是最重要的目标。它会在 package 阶段之后执行,将项目打包成一个可执行的 JAR 或 WAR 文件。 它会创建一个新的可执行 JAR/WAR,并将原始的 JAR/WAR 包含在其中。 这样,你就可以直接运行 java -jar your-app.jar 来启动 Spring Boot 应用程序。
-
-
==repackage goal 的主要作用是创建一个可执行的 JAR/WAR 文件。 Spring Boot 应用程序依赖于嵌入式 Web 服务器(例如 Tomcat、Jetty 或 Undertow),repackage goal 会将这些依赖和应用程序代码打包在一起,并配置好类加载器,使应用程序可以直接运行==。
-
2.属性注入到bean对象的方式
-
1.基于构造函数的注入这是最推荐的注入方式,因为它保证了 Bean 在创建时就拥有了所有必需的依赖项,并且可以强制执行不变性。
@Componentpublic class MyBean {private final String name;private final int value;@Autowired // Spring 4.3+ 可以省略 @Autowired 注解public MyBean(String name, @Value("${my.value}") int value) {this.name = name;this.value = value;}}2. 基于 Setter 方法的注入:
这种方式比较灵活,允许在 Bean 创建后修改依赖项。但是,它不能保证 Bean 在使用前已经初始化了所有必需的依赖项。
@Componentpublic class MyBean {private String name;private int value;@Autowiredpublic void setName(String name) {this.name = name;}@Autowired@Value("${my.value}")public void setValue(int value) {this.value = value;}}==3. 使用 @Value 注解注入属性值:==
@Value 注解可以将属性值、表达式结果、系统属性、环境变量等注入到 Bean 的字段或方法参数中。
-
注入 application.properties 中的属性:
@Value("${my.property}") private String myProperty; -
注入系统属性:
@Value("#{systemProperties['user.home']}") private String userHome; -
注入表达式结果:
@Value("#{2 * T(java.lang.Math).PI}") private double circumference; -
设置默认值:
@Value("${my.property:defaultValue}") private String myProperty;
4. 使用 @ConfigurationProperties 注解注入属性值:
@ConfigurationProperties 注解可以将一组相关的属性绑定到一个 Java Bean 中。这对于管理复杂的配置非常有用。
@Component@ConfigurationProperties(prefix = "my.config")public class MyConfig {private String property1;private int property2;// ... getters and setters}在 application.properties 中:
my.config.property1=value1my.config.property2=123==通常像数据库这些配置信息一般在spring boot框架启动后自动加载配置文件注入到应用程序中==
-
-
5. 注入其他 Bean:
==使用 @Autowired 或 @Resource 注解将其他 Bean 注入到当前 Bean 中==。
@Componentpublic class MyBean {@Autowiredprivate OtherBean otherBean;}
3.正则表达式
/** * /d 匹配数字0-9 java中对于字符需要一次转义 * &^ 以所匹配的结尾或开头 * \w匹配数字、26个英文字母或者下划线 * *前面出现0/多次 + 前面1/多次 * (?=.*\d) 先行断言,先行检查是否至少存在一个数字,.* 表示匹配任意字符(除了换行符)零次或多次 * {8,18}前面集合出现8-18次 * [] 其中至少出现一次 * ?: 表示前面的组是可选的 可出现或不出现 */常用正则表达式 NO("","不校验"), IP("([1-9]|[1-9]\\d|1\\d{2}|2[0-4]\\d|25[0-5])(\\.(\\d|[1-9]\\d|1\\d{2}|2[0-4]\\d|25[0-5])){3}", "IP地址"), POSITIVE_INTEGER("^[0-9]*[1-9][0-9]*$", "正整数"), NUMBER_LETTER_UNDER_LINE("^\\w+$", "由数字、26个英文字母或者下划线组成的字符串"), PHONE("(1[0-9])\\d{9}$", "手机号码"), COMMON("^[a-zA-Z0-9_\\u4e00-\\u9fa5]+$", "数字,字母,中文,下划线"), PASSWORD("^(?=.*\\d)(?=.*[a-zA-Z])[\\da-zA-Z~!@#$%^&*_]{8,18}$", "只能是数字,字母,特殊字符 8-18位"), ACCOUNT("^[a-zA-Z][0-9a-zA-Z_]*$", "字母开头,由数字、英文字母或者下划线组成"), MONEY("^[0-9]+(.[0-9]{1,2})?$", "金额");4.AOP切面(Aspect)
一般我们通过==注解(Annotation)==可以用来定义==切面的切入点(Pointcut)切入点可以在使用时赋值==例如校验登录,校验参数,而==切面去实现切入点的具体逻辑==。
@Target({ElementType.METHOD,ElementType.TYPE}) //该注解可以用于方法或者类@Retention(RetentionPolicy.RUNTIME) //该注解在运行时保留,可以在运行时通过反射访问// 定义注解@Target(ElementType.METHOD)@Retention(RetentionPolicy.RUNTIME)public @interface CheckLogin { }
@Target(ElementType.METHOD)@Retention(RetentionPolicy.RUNTIME)public @interface CheckParams { }
// 定义切面@Aspect@Componentpublic class SecurityAspect {
// 登录校验切入点 @Around("@annotation(CheckLogin)") public Object checkLogin(ProceedingJoinPoint joinPoint) throws Throwable { // ... 登录校验逻辑 ... return joinPoint.proceed(); }
// 参数校验切入点 @Before("@annotation(CheckParams)") //@Before是在切入点之前执行 public void checkParams(JoinPoint joinPoint) { // ... 参数校验逻辑 ... }}
// 使用注解@Servicepublic class MyService {
@CheckLogin public void loginRequiredMethod() { // ... 需要登录的方法逻辑 ... }
@CheckParams public void validateParamsMethod(String param1, int param2) { // ... 需要参数校验的方法逻辑 ... }
}2024/11/16
1.Java Servlet
-
1. Servlet 接口:
这是所有 Servlet 的基础接口。它定义了 Servlet 的生命周期方法,例如 init()、service() 和 destroy()。Spring Boot 中的控制器通常间接实现了这个接口,由 Spring MVC 框架进行适配。
- init(ServletConfig config): 在 Servlet 初始化时调用,用于设置 Servlet 的配置信息。
- service(ServletRequest req, ServletResponse res): 处理客户端请求的核心方法,根据请求类型(GET、POST 等)调用相应的方法。
- destroy(): 在 Servlet 销毁时调用,用于释放资源。
2. ==ServletRequest== 接口:
表示客户端的请求。它提供了访问请求参数、请求头、请求 URL 等信息的方法。Spring MVC 将其封装为 HttpServletRequest 对象。
- getParameter(String name): 获取指定名称的请求参数。
- getParameterValues(String name): 获取指定名称的多个请求参数值。
- getHeader(String name): 获取指定名称的请求头。
- getRequestURL(): 获取请求的 URL。
- getSession(): 获取与请求关联的 HttpSession 对象。
3. ==ServletResponse== 接口:
表示服务器对客户端的响应。它提供了设置响应头、响应状态码以及向客户端输出数据的方法。Spring MVC 将其封装为 HttpServletResponse 对象。
- setContentType(String type): 设置响应的内容类型。
- setStatus(int sc): 设置响应的状态码。
- getWriter(): 获取 PrintWriter 对象,用于向客户端输出文本数据。
- getOutputStream(): 获取 ServletOutputStream 对象,用于向客户端输出二进制数据。
4. ==HttpServletRequest 接口== (继承自 ServletRequest):
专用于 HTTP 协议的请求,提供了访问 HTTP 特定信息的方法,例如请求方法、请求 URI 等。
- getMethod(): 获取 HTTP 请求方法(GET、POST 等)。
- getRequestURI(): 获取请求的 URI。
- getContextPath(): 获取 Web 应用程序的上下文路径。
- getCookies(): 获取请求中的 Cookie。
设置 HTTP 请求的 Content-Type: 当客户端发送 JSON 数据到服务器时,也需要设置 Content-Type 头部,告诉服务器发送的数据类型。request.setHeader(CONTENT_TYPE, CONTENT_TYPE_VALUE);
5. ==HttpServletResponse== 接口 (继承自 ServletResponse):
专用于 HTTP 协议的响应,提供了设置 HTTP 特定响应头的方法,例如重定向、设置 Cookie 等。
- sendRedirect(String location): 重定向到指定的 URL。
- addCookie(Cookie cookie): 添加 Cookie 到响应。
- setHeader(String name, String value): 设置响应头。
**设置 HTTP 响应的 Content-Type:** 当服务器返回 JSON 数据给客户端时,需要设置 Content-Type 头部为 "application/json;charset=UTF-8",以便客户端能够正确解析数据。response.setHeader(CONTENT_TYPE, CONTENT_TYPE_VALUE);
6. ==HttpSession== 接口:
表示客户端的会话。它用于在多个请求之间存储用户特定的数据。
- setAttribute(String name, Object value): 将数据存储到会话中。
- getAttribute(String name): 从会话中获取数据。
- invalidate(): 使会话失效。
7. ==ServletContext== 接口:
表示 Web 应用程序的上下文。它提供了访问 Web 应用程序的配置信息和资源的方法。
- getInitParameter(String name): 获取 Web 应用程序的初始化参数。
- getRealPath(String path): 获取指定路径的实际文件系统路径。
- getAttribute(String name)
// RequestContextHolder: RequestContextHolder是 Spring 提供的一个工具类,它可以用来获取当前线程的请求信息。
// getRequestAttributes: getRequestAttributes() 方法返回一个 RequestAttributes 对象,它包含了当前请求的相关信息,包括 HttpServletRequest 对象。
// ServletRequestAttributes: RequestContextHolder.getRequestAttributes() 返回的 RequestAttributes 对象是一个接口,它无法直接访问 HttpServletRequest 对象。// 我们需要将其强制转换为 ServletRequestAttributes 类型,才能获取 HttpServletRequest 对象。//// ServletRequestAttributes 是 Spring 提供的一个实现类,它扩展了 RequestAttributes 接口,并提供了获取 HttpServletRequest 对象的方法。// ServletRequestAttributes 类中的 getRequest() 方法用于获取与当前请求相关的 HttpServletRequest 对象。
// HttpServletRequest 对象中有一个 getSession() 方法,可以获取与该请求相关的 HttpSession 对象。
// session.getAttribute(Constants.SESSION_KEY): 从 HttpSession 对象中获取名为 Constants.SESSION_KEY 的属性值。
HttpServletRequest request = ((ServletRequestAttributes) RequestContextHolder.getRequestAttributes()).getRequest(); // 获取 HttpServletRequest 对象 HttpSession session = request.getSession(); SessionWebUserDto sessionUser = (SessionWebUserDto) session.getAttribute(Constants.SESSION_KEY);现如今springboot已经极大的简化了Java servlet的开发 例如
-
1. 内嵌 Servlet 容器:
Spring Boot 内嵌了 Tomcat、Jetty 或 Undertow 等 Servlet 容器,无需手动部署 WAR 文件。 你只需运行 Spring Boot 应用程序,它就会自动启动内嵌的 Servlet 容器,并将你的应用程序部署到其中。 这大大简化了部署过程,也方便了开发和测试。
2. 自动配置:
Spring Boot 的自动配置机制会根据你项目中的依赖自动配置 Servlet 容器以及其他相关的组件,例如 Spring MVC。 你无需编写繁琐的 XML 配置文件或 Java 配置类来配置 Servlet 容器、监听器、过滤器等。 Spring Boot 会根据你的需要自动完成这些配置。
3. Starter 依赖:
Spring Boot Starter 是一组方便的依赖描述符,可以帮助你快速添加项目所需的依赖。 例如,spring-boot-starter-web starter 依赖包含了 Spring MVC 和内嵌 Servlet 容器所需的全部依赖。 你只需添加一个 starter 依赖,即可开始 Web 开发。
4. 简化的 Servlet API 使用:
Spring Boot 提供了更高级的抽象,例如 Spring MVC,来简化 Servlet API 的使用。 你可以使用注解(例如 @Controller、@RequestMapping 等)来定义控制器和处理请求,而无需直接实现 Servlet 接口或处理 HttpServletRequest 和 HttpServletResponse 对象。
5. 简化的部署:
Spring Boot 应用程序可以被打包成可执行的 JAR 文件,可以直接运行。 你无需将应用程序部署到外部 Servlet 容器中。 这简化了部署过程,也使得应用程序更易于移植。
==但完全隐藏 Servlet API 并不现实,某些情况下,开发者需要直接访问 Servlet API 来实现特定的功能或进行底层控制。例如,操作 Cookie、设置缓存控制、处理文件下载等。==
2.java.lang.reflect(反射)
==反射 (Reflection) 是指在程序运行时,能够获取自身类型信息的能力。==
包提供了用于获取和操作类、接口、字段、方法和构造函数等运行时类型信息的类和接口。它允许在运行时检查和修改程序的结构和行为,是实现动态代理、注解处理、依赖注入等高级特性的基础。
- 核心类和接口:
-
Class<T>: 表示类的类型,可以通过它获取类的名称、修饰符、父类、接口、字段、方法、构造函数等信息。
- ==getName(): 获取类的完全限定名。==
- getSimpleName(): 获取类的简单名称。
- getSuperclass(): 获取父类。
- getInterfaces(): 获取实现的接口。
- getModifiers(): 获取修饰符(public, private, static 等)。
- ==getDeclaredFields(): 获取声明的字段。== (包括私有与保护)
- getFields(): 获取所有公共字段(包括继承的)。
- getDeclaredMethods(): 获取声明的方法。
- ==getMethods(): 获取所有公共方法(包括继承的)。==
- getDeclaredConstructors(): 获取声明的构造函数。
- getConstructors(): 获取所有公共构造函数。
- newInstance(): 创建新的实例(需要无参构造函数)。
- ==.class 编译时知道类的存在==
- ==forName(String className): 通过类名获取 Class 对象。运行时知道类的存在==
-
Field: 表示类的字段。 (即类的属性)
- getName(): 获取字段名。
- getType(): 获取字段类型。
- getModifiers(): 获取修饰符。
- ==setAccessible(true): 允许访问私有字段。==
- get(Object obj): 获取字段的值。
- set(Object obj, Object value): 设置字段的值。
-
Method: 表示类的方法。
- getName(): 获取方法名。
- getReturnType(): 获取返回类型。
- ==getParameterTypes(): 获取参数类型数组。==
- getModifiers(): 获取修饰符。
- setAccessible(true): 允许访问私有方法。
- invoke(Object obj, Object… args): 调用方法。
-
Constructor: 表示类的构造函数。
- getParameterTypes(): 获取参数类型数组。
- getModifiers(): 获取修饰符。
- setAccessible(true): 允许访问私有构造函数。
- newInstance(Object… args): 创建新的实例。
-
==Parameter 类的常用方法:==
- ==getName==(): 返回参数的名称。 需要注意的是,参数名称在编译后的字节码中默认是不保留的。要获取参数名称,需要在编译时使用 -parameters 选项。
- ==getType==(): 返回参数的类型,以 Class 对象表示。
- ==getParameterizedType==(): 返回参数的参数化类型。这对于泛型类型尤其有用,可以获取更详细的类型信息,例如 List<String> 的参数化类型是 String。
- ==getAnnotatedType==(): 返回参数的带注解的类型,它包含了参数的类型信息以及参数上的注解。
- getModifiers(): 返回参数的修饰符(例如 final)。 可以使用 java.lang.reflect.Modifier 类来解析这些修饰符。
- isNamePresent(): 检查参数名称是否可用。 只有在编译时使用 -parameters 选项的情况下,参数名称才可用。
- ==getAnnotations==(): 返回参数上的所有注解。
- getAnnotation(Class<T> annotationClass): 返回参数上指定类型的注解。
- getDeclaredAnnotations(): 返回直接在参数上声明的注解,不包括继承的注解。
- isVarArgs(): 检查参数是否为可变参数(varargs)。
-
应用场景:
- 框架开发 (例如 Spring): 用于实现依赖注入、AOP 等功能。
- 测试工具 (例如 JUnit): 用于访问私有成员和模拟对象行为。
- 代码生成工具: 用于生成代码。
- ORM 框架 (例如 Hibernate): 用于将对象映射到数据库表。
- 动态代理: 用于创建在运行时实现接口的代理对象。
import java.lang.reflect.*;
public class ReflectionExample {
public static void main(String[] args) throws Exception { Class<?> cls = Class.forName("java.lang.String"); // 声明一个名为 cls 的变量来存储 String 类的 Class 对象。? 表示通配符,可以代表任何类型。
System.out.println("Class Name: " + cls.getName()); //获取类的完全限定名(fully qualified name),对于 String 类,结果是 java.lang.String。
Method[] methods = cls.getMethods(); //获取 String 类及其父类中所有 public 方法,并返回一个 Method 对象数组。 for (Method method : methods) { System.out.println("Method: " + method.getName()); }
Field[] fields = cls.getDeclaredFields(); //获取 String 类中声明的 所有 字段( for (Field field : fields) { System.out.println("Field: " + field.getName()); }
Constructor<?>[] constructors = cls.getConstructors(); //获取 String 类中所有 public 构造函数 for (Constructor<?> constructor : constructors) { System.out.println("Constructor: " + constructor.getName()); }
// 创建String实例 String str = (String) cls.getConstructor(String.class).newInstance("Hello"); System.out.println(str);
}}import java.lang.reflect.*;import java.util.List; // 导入 List 接口
public class ParameterExample {
// 定义一个方法,用于打印方法参数的信息 public static void printParameterInfo(Method method) { // 获取方法的参数列表 Parameter[] parameters = method.getParameters();
for (Parameter parameter : parameters) { // 打印参数名称 System.out.println("Parameter Name: " + parameter.getName());
// 打印参数类型 System.out.println("Parameter Type: " + parameter.getType());
// 打印参数化类型 (对于泛型参数很有用) System.out.println("Parameterized Type: " + parameter.getParameterizedType());
// 打印参数是否为可变参数 (varargs) System.out.println("Is VarArgs: " + parameter.isVarArgs());
// 打印参数上的注解 System.out.println("Annotations:"); //getAnnotations()内加上参数是获取此参数上该类型的注解 for (Annotation annotation : parameter.getAnnotations()) { System.out.println(" " + annotation); }
System.out.println("------"); } }
// 示例方法,包含不同类型的参数和一个注解 public void exampleMethod(String name, int age, @Deprecated List<String> hobbies) {
}
public static void main(String[] args) throws NoSuchMethodException {
//ParameterExample.class: 获取 ParameterExample 类的 Class 对象。 Class 对象表示 Java 中的类,包含类的元数据信息。 Method method = ParameterExample.class.getMethod("exampleMethod", String.class, int.class, List.class);
printParameterInfo(method); }}
输出Parameter Name: arg0Parameter Type: class java.lang.StringParameterized Type: class java.lang.StringIs VarArgs: falseAnnotations:------Parameter Name: arg1Parameter Type: intParameterized Type: intIs VarArgs: falseAnnotations:------Parameter Name: arg2Parameter Type: interface java.util.ListParameterized Type: java.util.List<java.lang.String>Is VarArgs: falseAnnotations: @java.lang.Deprecated()------2024//11/17
1.String.valueOf(value) 与value.String区别
String.valueOf(value) 和 value.toString() 的主要区别在于如何处理 null 值:
- String.valueOf(value): ==如果 value 为 null,String.valueOf(value) 会返回字符串 “null”==。 它不会抛出 NullPointerException。
- value.toString(): 如果 value 为 null,调用 value.toString() ==会抛出 NullPointerException==。
2.java.util.regex
** Pattern 类:**
Pattern 类表示编译后的正则表达式。它是一个不可变的类,一旦创建就不能修改。
- ==Pattern.compile(String regex):== 将指定的正则表达式字符串编译成 Pattern 对象。这是使用正则表达式的第一步。
- ==Pattern.matches(String regex, CharSequence input):== 这是一个静态方法,用于快速判断一个字符串是否匹配指定的正则表达式。==等价于 Pattern.compile(regex).matcher(input).matches()==。 如果只需要进行一次匹配,可以使用这个方法,效率更高,==但若多次使用一个正则表达式去匹配推荐先编译正则表达式==。
- pattern.matcher(CharSequence input): 创建一个 Matcher 对象,用于将 Pattern 对象与输入字符串进行匹配。
- pattern.flags(): 返回编译时指定的标志,例如 Pattern.CASE_INSENSITIVE。
Matcher 类:
Matcher 类用于对字符串执行匹配操作。
- ==matcher.matches():== 尝试将整个输入序列与模式匹配。
- matcher.find(): 尝试查找输入序列中与模式匹配的下一个子序列。
3.boolean 和 Boolean
- boolean 是 Java 的基本数据类型 (primitive type),而 Boolean 是 boolean 的包装类 (wrapper class)。
- 内存使用: boolean 直接存储布尔值(true 或 false),占用更少的内存。Boolean 则是一个对象,存储的是对象的引用,占用更多的内存。
- 默认值: boolean 的默认值为 false。Boolean 的默认值为 null。
- 性能: boolean 的操作通常更高效,因为它不需要进行对象的创建和销毁。Boolean 的操作涉及到对象的装箱和拆箱,会有一定的性能开销,但在现代 JVM 中,这个开销已经很小了。
- 空值: ==boolean 不能为 null==,而 ==Boolean 可以为 null==。 这使得 Boolean 更适合表示可能不存在的值,例如数据库中的一个可空字段。
- 方法: Boolean 作为包装类,提供了一些有用的方法,例如 parseBoolean()、toString()、equals() 等,而 boolean 没有这些方法。
- 泛型: ==Boolean 可以用于泛型类型==,而 boolean 不可以。 例如,你可以声明一个 List<Boolean>,但不能声明一个 List<boolean>。
2024/11/20
1.java集合
Collection 这是所有集合的根接口,定义了集合的基本操作,如添加、删除、检查元素是否存在等。 主要方法包括:add, remove, contains, size, isEmpty, iterator 等。
1. List 接口及其主要实现类
-
特点: 有序集合,允许重复元素,可以通过索引访问元素。
-
常用实现类:
- ArrayList:基于动态数组实现,随机访问速度快,插入和删除操作相对较慢,线程不安全。
- ==add(E element): 在列表末尾添加元素。==
- add(int index, E element): 在指定索引位置插入元素。
- ==get(int index): 获取指定索引位置的元素。==
- ==set(int index, E element): 修改指定索引位置的元素。==
- ==remove(int index): 删除指定索引位置的元素。==
- ==remove(Object o): 删除指定的元素。==
- ==size(): 返回列表中元素的数量。==
- ==isEmpty(): 判断列表是否为空。==
- ==contains(Object o): 判断列表是否包含指定的元素。==
- clear(): 清空列表。
- iterator(): 返回一个迭代器,用于遍历列表中的元素。
- LinkedList:基于双向链表实现,插入和删除操作速度快,随机访问速度慢,线程不安全。
- addFirst(E e): 在列表开头添加元素。
- addLast(E e): 在列表末尾添加元素 (等同于 add(e))。
- getFirst(): 获取列表的第一个元素。
- getLast(): 获取列表的最后一个元素。
- removeFirst(): 删除并返回列表的第一个元素。
- removeLast(): 删除并返回列表的最后一个元素。
- offerFirst(E e)/offerLast(E e): 添加元素到列表开头/末尾,如果操作成功返回 true,否则返回 false。
- peekFirst()/peekLast(): 获取但不删除列表的第一个/最后一个元素,如果列表为空,则返回 null。
- pollFirst()/pollLast(): 获取并删除列表的第一个/最后一个元素,如果列表为空,则返回 null
- Vector:与 ArrayList 类似,但线程安全,性能略低于 ArrayList。
- ArrayList:基于动态数组实现,随机访问速度快,插入和删除操作相对较慢,线程不安全。
-
适用场景: 存储需要保持顺序的数据,例如用户列表、商品列表等。
2. Set 接口及其主要实现类
-
特点: 无序集合,不允许重复元素。
-
常用实现类:
- HashSet:基于哈希表实现,元素的添加和查找速度快,不保证元素的顺序,线程不安全。
- TreeSet:基于红黑树实现,元素自动排序,线程不安全。
- ==add(E element): 添加元素到集合中。==
- ==remove(Object o): 从集合中删除指定的元素。==
- ==contains(Object o): 判断集合中是否包含指定的元素。==
- ==size(): 返回集合中元素的数量。==
- ==first(): 返回集合中的第一个元素(最小的元素)。==
- ==last(): 返回集合中的最后一个元素(最大的元素)。==
- lower(E e): 返回小于给定元素的最大元素。
- higher(E e): 返回大于给定元素的最小元素。
- floor(E e): 返回小于等于给定元素的最大元素。
- ceiling(E e): 返回大于等于给定元素的最小元素。
-
适用场景: 去除重复元素,例如统计用户访问的页面、存储不重复的关键词等。
3. Queue 接口及其主要实现类
-
特点: 队列,遵循 FIFO(先进先出)原则。
-
常用实现类:
- LinkedList:实现了 Deque 接口,可以用作双端队列,线程不安全。
- PriorityQueue:优先队列,元素根据优先级排序,线程不安全。
- ArrayBlockingQueue:有界阻塞队列,基于数组实现,线程安全。
- LinkedBlockingQueue:可选有界阻塞队列,基于链表实现,线程安全。
- ConcurrentLinkedQueue:无界非阻塞队列,基于链表实现,线程安全,适用于高并发场景。
-
适用场景: 实现生产消费者模型、任务调度等。
4. Map 接口及其主要实现类
-
特点: 键值对集合,每个键映射到一个值,键不能重复,值可以重复。
-
常用实现类:
- HashMap:基于哈希表实现,键值对的添加和查找速度快,不保证元素的顺序,线程不安全。
- ==put(K key, V value): 将指定的键值对添加到 Map 中。==
- ==get(Object key): 获取指定键对应的值。==
- ==remove(Object key): 删除指定键对应的键值对。==
- ==containsKey(Object key): 判断 Map 中是否包含指定的键。==
- ==containsValue(Object value): 判断 Map 中是否包含指定的值。==
- ==size(): 返回 Map 中键值对的数量。==
- ==isEmpty(): 判断 Map 是否为空。==
- clear(): 清空 Map。
- keySet(): 返回 Map 中所有键的 Set 视图。
- values(): 返回 Map 中所有值的 Collection 视图。
- entrySet(): 返回 Map 中所有键值对的 Set 视图。
- TreeMap:基于红黑树实现,键值对按照键排序,线程不安全。
- put(K key, V value): 将指定的键值对添加到 Map 中。
- get(Object key): 获取指定键对应的值。
- remove(Object key): 删除指定键对应的键值对。
- firstKey(): 返回 Map 中最小的键。
- lastKey(): 返回 Map 中最大的键。
- lowerKey(K key): 返回小于给定键的最大键。
- higherKey(K key): 返回大于给定键的最小键。
- floorKey(K key): 返回小于等于给定键的最大键。
- ceilingKey(K key): 返回大于等于给定键的最小键。
- LinkedHashMap:继承自 HashMap,使用链表维护键值对的插入顺序,线程不安全。
- ConcurrentHashMap:线程安全的 HashMap,性能优于 Hashtable,适用于高并发场景。
- HashMap:基于哈希表实现,键值对的添加和查找速度快,不保证元素的顺序,线程不安全。
-
适用场景: 存储键值对数据,例如用户信息、配置信息等。
5. Deque 接口及其主要实现类
-
特点: 双端队列,可以在队列的两端进行插入和删除操作。
-
常用实现类:
- LinkedList:实现了 Deque 接口,可以用作双端队列,线程不安全。
- ArrayDeque:基于数组实现的双端队列,线程不安全。
- ConcurrentLinkedDeque:线程安全的双端队列,适用于高并发场景。
-
适用场景: 实现栈、队列等数据结构。
2.异常处理
java中异常类结构:
**Throwable:**Java 语言中所有错误或异常的超类
-
Error (错误): Error 表示严重的系统问题,通常是应用程序无法恢复的。例如,OutOfMemoryError、StackOverflowError 等。一般情况下,应用程序不应该尝试捕获 Error。
-
Exception (异常): Exception 表示程序运行过程中可能出现的异常情况,通常是可以被应用程序处理的。
- Checked Exception (受检异常): 除了 RuntimeException 及其子类以外,其他的异常都属于受检异常。编译器会强制要求你处理这类异常,要么使用 try-catch 块捕获,要么在方法签名中使用 throws 关键字声明抛出。例如,==IOException、SQLException、ClassNotFoundException== 等。
- Unchecked Exception (非受检异常/运行时异常): ==RuntimeException== 及其子类都属于非受检异常。编译器不会强制要求你处理这类异常。例如,NullPointerException、ArrayIndexOutOfBoundsException、IllegalArgumentException、ArithmeticException 等。
-
自定义异常:自定义异常通常继承自 Exception 或 RuntimeException。
Throwable 的常用方法
- ==getMessage(): 返回异常的描述信息。==
- ==getCause(): 返回导致当前异常的原因,可以形成异常链。==
- ==printStackTrace(): 打印异常的堆栈跟踪信息,堆栈跟踪显示了异常发生时程序的调用栈,包括文件名、方法名和行号。 这可以帮助开发者精确定位代码中出现错误的位置。==
- fillInStackTrace(): 填充堆栈跟踪信息。在自定义异常时,可以通过重写该方法来避免填充堆栈信息,从而提高性能 (就像你在 BusinessException 中做的那样)。
- toString(): 返回异常的字符串表示形式,通常包含异常的类名和描述信息。
package com.easypan.exception;
import com.easypan.entity.enums.ResponseCodeEnum;
// BusinessException 类,继承自 RuntimeException,用于表示业务异常public class BusinessException extends RuntimeException {
// 私有属性,用于存储异常的枚举码 private ResponseCodeEnum codeEnum;
// 私有属性,用于存储异常的代码值 private Integer code;
// 私有属性,用于存储异常的错误信息 private String message;
// 构造方法,接收错误信息和异常对象,用于创建 BusinessException 对象 public BusinessException(String message, Throwable e) { // 调用父类 RuntimeException 的构造方法,初始化错误信息和异常对象 super(message, e); // 设置 BusinessException 的错误信息 this.message = message; }
// 构造方法,接收错误信息,用于创建 BusinessException 对象 public BusinessException(String message) { // 调用父类 RuntimeException 的构造方法,初始化错误信息 super(message); // 设置 BusinessException 的错误信息 this.message = message; }
// 构造方法,接收异常对象,用于创建 BusinessException 对象 public BusinessException(Throwable e) { // 调用父类 RuntimeException 的构造方法,初始化异常对象 super(e); }
// 构造方法,接收 ResponseCodeEnum 对象,用于创建 BusinessException 对象 public BusinessException(ResponseCodeEnum codeEnum) { // 调用父类 RuntimeException 的构造方法,初始化错误信息 super(codeEnum.getMsg()); // 设置 BusinessException 的枚举码、代码值和错误信息 this.codeEnum = codeEnum; this.code = codeEnum.getCode(); this.message = codeEnum.getMsg(); }
// 构造方法,接收代码值和错误信息,用于创建 BusinessException 对象 public BusinessException(Integer code, String message) { // 调用父类 RuntimeException 的构造方法,初始化错误信息 super(message); // 设置 BusinessException 的代码值和错误信息 this.code = code; this.message = message; }
// 获取异常的枚举码 public ResponseCodeEnum getCodeEnum() { return codeEnum; }
// 获取异常的代码值 public Integer getCode() { return code; }
// 重写 getMessage 方法,返回异常的错误信息 @Override public String getMessage() { return message; }
// 重写 fillInStackTrace 方法,用于避免填充堆栈信息,提高效率 // 业务异常一般不需要堆栈信息,因为堆栈信息可能包含敏感信息,而且会影响性能 @Override public Throwable fillInStackTrace() { return this; }}3.日志记录
Spring Boot 推荐的日志记录方式。
- SLF4j (Simple Logging Facade for Java): 这是一个日志门面,它本身不提供具体的日志实现,而是允许你在部署时选择不同的日志库,例如 Logback、Log4j2、Java Util Logging 等。
- Logback: 一个功能强大的日志实现库,通常作为 SLF4j 的默认实现。
SLF4j 和 Logback
private static Logger logger = LoggerFactory.getLogger(?.class);配置 Logback:
Spring Boot 默认使用 logback-spring.xml 或 logback.xml 配置文件。
你可以在 src/main/resources 目录下创建这些文件来配置日志输出格式、级别、目标等。
记录日志:
- logger.trace(“跟踪信息”);
- logger.debug(“调试信息”);
- logger.info(“普通信息”);
- logger.warn(“警告信息”);
- logger.error(“错误信息”, exception); // 记录异常信息,包含堆栈跟踪
2024/11/25
1.Java String
1. 基本操作:
- ==length()====: 返回字符串的长度(字符数)。==
- charAt(int index): 返回指定索引位置的字符。
- indexOf(String str): 返回指定子字符串第一次出现的索引,如果找不到则返回 -1。
- lastIndexOf(String str): 返回指定子字符串最后一次出现的索引,如果找不到则返回 -1。
- ==substring(int beginIndex)====: 返回从指定索引开始到字符串末尾的子字符串。==
- ==substring(int beginIndex, int endIndex)====: 返回从指定起始索引到结束索引(不包含)的子字符串。==
- concat(String str): 将指定字符串连接到当前字符串的末尾。 等价于 + 操作符。
- toCharArray(): 将字符串转换为字符数组。
2. 比较:
- ==equals(Object anObject)====: 比较字符串是否相等(区分大小写)。==
- ==equalsIgnoreCase(String anotherString)====: 比较字符串是否相等(忽略大小写)。==
- compareTo(String anotherString): 按字典顺序比较两个字符串。
- compareToIgnoreCase(String str): 按字典顺序比较两个字符串(忽略大小写)。
- ==startsWith(String prefix)====: 检查字符串是否以指定前缀开头。==
- ==endsWith(String suffix)====: 检查字符串是否以指定后缀结尾。==
- ==contentEquals(StringBuffer sb)====: 将字符串与指定的 StringBuffer 比较。==
3. 查找和替换:
- ==contains(CharSequence s)====: 检查字符串是否包含指定的字符序列。==
- ==replace(char oldChar, char newChar)====: 将字符串中所有出现的旧字符替换为新字符。==
- ==replaceAll(String regex, String replacement)====: 使用正则表达式替换所有匹配的子字符串。==
- replaceFirst(String regex, String replacement): 使用正则表达式替换第一个匹配的子字符串。
4. 大小写转换:
- toLowerCase(): 将字符串转换为小写。
- toUpperCase(): 将字符串转换为大写。
5. 空白处理:
- ==trim()====: 去除字符串开头和结尾的空白字符。==
- isBlank() (Java 11+): 检查字符串是否为空白或只包含空白字符.
- ==isEmpty()====: 检查字符串是否为空。==
6. 格式化:
- ==format(String format, Object… args)====: 使用指定的格式字符串和参数创建格式化字符串。==
- ==valueOf(Object obj)====: 将各种类型的值转换为字符串。==
String name = "Alice"; int age = 30; double price = 19.99;String formattedString = String.format("My name is %s, I am %d years old, and the price is $%.2f", name, age,price); System.out.println(formattedString); // 输出: My name is Alice, I am 30 years old, and the price is $19.99
7. 分割和连接:
- ==split(String regex)====: 使用正则表达式分割字符串。==
- join(CharSequence delimiter, CharSequence… elements) (Java 8+): 使用指定的分隔符连接多个字符串。
8. 字符串构建器:
虽然不是 String 类的方法,但 StringBuilder 和 StringBuffer 类对于高效地构建和修改字符串非常重要,尤其是在循环中操作字符串时,应该使用 StringBuilder 或 StringBuffer,而不是直接使用 String 的 + 或 concat() 方法。
- 可变性: StringBuilder 对象的内容是可以修改的,这意味着你可以追加、插入、删除或替换字符,而无需创建新的字符串对象。 与之相反,String 对象是不可变的,每次修改都会创建一个新的 String 对象,这在频繁修改字符串时会造成性能损耗。
- 线程不安全: StringBuilder 不是线程安全的,如果需要在多线程环境下使用,应该使用 StringBuffer,它是线程安全的版本。 在单线程环境下,StringBuilder 的性能通常优于 StringBuffer。
- 初始容量: StringBuilder 内部维护一个字符数组来存储字符串内容。 创建 StringBuilder 对象时可以指定初始容量,如果预计字符串会很长,预先分配足够的容量可以避免频繁的数组扩容,从而提高性能。
常用方法:
- StringBuilder(): 创建一个空的 StringBuilder 对象。
- StringBuilder(int capacity): 创建一个指定初始容量的 StringBuilder 对象。
- StringBuilder(String str): 创建一个包含指定字符串的 StringBuilder 对象。
- append(Object obj): 将任意对象的字符串表示形式追加到 StringBuilder 的末尾。
- append(String str): 将指定的字符串追加到 StringBuilder 的末尾。
- append(char c): 将指定的字符追加到 StringBuilder 的末尾。
- insert(int offset, String str): 在指定位置插入字符串。
- delete(int start, int end): 删除指定范围内的字符。
- deleteCharAt(int index): 删除指定位置的字符。
- replace(int start, int end, String str): 替换指定范围内的字符。
- reverse(): 反转字符串。
- toString(): 将 StringBuilder 对象转换为 String 对象。
- length(): 返回当前 StringBuilder 对象的长度。
- capacity(): 返回当前 StringBuilder 对象的容量。
- setLength(int newLength): 设置 StringBuilder 对象的长度。 如果新长度小于当前长度,则截断字符串;如果新长度大于当前长度,则用空字符填充。
2.工具包(org.apache.commons.lang3)
-
1. 字符串工具类 StringUtils
- isBlank(String str): 检查字符串是否为空白(null、空字符串或只包含空格)。比 isEmpty() 更常用,因为它考虑了空格的情况。
- isEmpty(String str): 检查字符串是否为空(null 或空字符串)。
- trim(String str): 去除字符串两端的空格。
- substring(String str, int start): 截取字符串。
- join(Object[] array, String separator): 将数组元素用指定分隔符连接成字符串。
- split(String str, String separator): 用指定分隔符分割字符串。
- replace(String text, String searchString, String replacement): 替换字符串。
- equalsIgnoreCase(String str1, String str2): 忽略大小写比较两个字符串。
- startsWith(String str, String prefix): 检查字符串是否以指定前缀开头。
- endsWith(String str, String suffix): 检查字符串是否以指定后缀结尾。
- contains(String str, String searchStr): 检查字符串是否包含指定子串。
2. ==数字工具类 NumberUtils==
- toInt(String str, int defaultValue): 将字符串转换为 int,如果转换失败则返回默认值。
- toLong(String str, long defaultValue): 将字符串转换为 long,如果转换失败则返回默认值。
- toDouble(String str, double defaultValue): 将字符串转换为 double,如果转换失败则返回默认值。
- isDigits(String str): 检查字符串是否只包含数字。
- isNumber(String str): 检查字符串是否是一个有效的数字(包括整数、小数、科学计数法等)。
- min(int[] array)/max(int[] array): 查找数组中的最小/最大值。 类似方法也适用于 long, double, float 等。
3. ==数组工具类 ArrayUtils==
- isEmpty(Object[] array): 检查数组是否为空。
- isNotEmpty(Object[] array): 检查数组是否非空。
- ==contains(Object[] array, Object objectToFind): 检查数组是否包含指定元素。 ==ArrayUtils.contains(appConfig.getAdminEmails().split(”,”), email)
- add(Object[] array, Object element): 向数组中添加元素,返回一个新的数组。
- remove(Object[] array, int index): 从数组中移除指定索引的元素,返回一个新的数组。
- clone(Object[] array): 克隆数组。
4. 集合工具类 CollectionUtils
- isEmpty(Collection<?> collection): 检查集合是否为空。
- isNotEmpty(Collection<?> collection): 检查集合是否非空。
- containsAny(Collection<?> coll1, Collection<?> coll2): 检查 coll1 是否包含 coll2 中的任何元素。
- intersection(Collection<?> coll1, Collection<?> coll2): 返回 coll1 和 coll2 的交集。
- union(Collection<?> coll1, Collection<?> coll2): 返回 coll1 和 coll2 的并集。
5. 日期工具类 DateUtils
- parseDate(String str, String… parsePatterns): 将字符串解析成日期对象。
- format(Date date, String pattern): 将日期对象格式化成字符串。
- addDays(Date date, int amount): 在日期上添加指定天数。 类似方法还有 addYears, addMonths, addWeeks, addHours, addMinutes, addSeconds, addMilliseconds.
6.RandomStringUtils 生成随机字符串
-
==random(int count, boolean letters, boolean numbers) 生成字符串长度,是否生成字母,是否生成数字==
-
在SpringBoot中引入该工具包
<dependency> <groupId>org.apache.commons</groupId> <artifactId>commons-lang3</artifactId> <version>3.x</version></dependency>3.java.time
- ==LocalDate====: 表示日期,例如 2024-03-15,不包含时间和时区信息。==
- ==LocalTime====: 表示时间,例如 10:30:45,不包含日期和时区信息。==
- ==LocalDateTime====: 表示日期和时间,例如 2024-03-15T10:30:45,不包含时区信息。==
- ZonedDateTime: 表示日期、时间和时区,例如 2024-03-15T10:30:45+08:00[Asia/Shanghai]。
- Instant: 表示时间戳,以 Unix 元年(1970-01-01T00:00:00Z)开始的秒数和纳秒数来表示时间。
- Duration: 表示两个时间点之间的时间差,以秒和纳秒为单位。
- Period: 表示两个日期之间的时间差,以年、月、日为单位。
- ==DateTimeFormatter====: 用于格式化和解析日期时间字符串。==
- ZoneId & ZoneOffset: 表示时区。ZoneOffset 用于表示固定的时区偏移量,例如 +08:00;ZoneId 用于表示更复杂的时区规则,例如 “Asia/Shanghai”。
import java.time.*;import java.util.Date;
public class DateTimeExamples {
public static void main(String[] args) {
// 2.1 获取当前时间
LocalDate currentDate = LocalDate.now(); // 获取当前日期 System.out.println("Current Date: " + currentDate);
LocalTime currentTime = LocalTime.now(); // 获取当前时间 System.out.println("Current Time: " + currentTime);
LocalDateTime currentDateTime = LocalDateTime.now(); // 获取当前日期时间 System.out.println("Current DateTime: " + currentDateTime);
ZonedDateTime currentZonedDateTime = ZonedDateTime.now(); // 获取当前日期时间,包含时区信息 System.out.println("Current ZonedDateTime: " + currentZonedDateTime);
Instant currentInstant = Instant.now(); // 获取当前时间戳,以UTC时间表示 System.out.println("Current Instant: " + currentInstant);
// 2.2 创建指定时间
LocalDate date = LocalDate.of(2024, 3, 15); // 创建指定日期 System.out.println("Specific Date: " + date);
LocalTime time = LocalTime.of(10, 30, 45); // 创建指定时间 System.out.println("Specific Time: " + time);
LocalDateTime dateTime = LocalDateTime.of(2024, 3, 15, 10, 30, 45); // 创建指定日期时间 System.out.println("Specific DateTime: " + dateTime);
ZonedDateTime zonedDateTime = ZonedDateTime.of(2024, 3, 15, 10, 30, 45, 0, ZoneId.of("Asia/Shanghai")); // 创建指定日期时间,包含时区信息 System.out.println("Specific ZonedDateTime: " + zonedDateTime);
Instant instant = Instant.parse("2024-03-15T02:30:45Z"); // 从字符串解析时间戳,注意"Z"表示UTC时间 System.out.println("Specific Instant: " + instant);
// 2.3 格式化和解析
DateTimeFormatter formatter = DateTimeFormatter.ofPattern("yyyy-MM-dd HH:mm:ss"); // 自定义格式 String formattedDateTime = currentDateTime.format(formatter); // 将日期时间格式化为字符串 System.out.println("Formatted DateTime: " + formattedDateTime);
LocalDateTime parsedDateTime = LocalDateTime.parse("2024-03-15 10:30:45", formatter); // 将字符串转换为日期/时间对象 System.out.println("Parsed DateTime: " + parsedDateTime);
DateTimeFormatter isoFormatter = DateTimeFormatter.ISO_DATE_TIME; // ISO 8601 标准格式 String isoFormatted = currentDateTime.format(isoFormatter); // 使用 System.out.println("ISO Formatted DateTime: " + isoFormatted);
// 2.4 日期时间计算
LocalDateTime nextWeek = currentDateTime.plusWeeks(1); // 加一周 System.out.println("Next Week: " + nextWeek);
LocalDate yesterday = currentDate.minusDays(1); // 减一天 System.out.println("Yesterday: " + yesterday);
Duration duration = Duration.between(instant, Instant.now()); // 计算两个时间点之间的时间差(秒和纳秒) System.out.println("Duration: " + duration.getSeconds() + " seconds");
Period period = Period.between(LocalDate.of(2023, 1, 1), LocalDate.now()); // 计算两个日期之间的时间差(年、月、日) System.out.println("Period: " + period.getYears() + " years, " + period.getMonths() + " months, " + period.getDays() + " days");
long daysBetween = ChronoUnit.DAYS.between(LocalDate.of(2023, 1, 1), LocalDate.now()); // 计算两个日期之间的天数差 System.out.println("Days Between: " + daysBetween);
// 2.5 时区转换
ZonedDateTime zonedDateTimeTokyo = currentDateTime.atZone(ZoneId.of("Asia/Tokyo")); // 将 LocalDateTime 转换为 ZonedDateTime,指定时区 System.out.println("Tokyo ZonedDateTime: " + zonedDateTimeTokyo);
LocalDateTime localDateTimeFromTokyo = zonedDateTimeTokyo.toLocalDateTime(); // 将 ZonedDateTime 转换为 LocalDateTime,丢失时区信息 System.out.println("LocalDateTime from Tokyo ZonedDateTime: " + localDateTimeFromTokyo);
Instant utcInstant = zonedDateTimeTokyo.toInstant(); // 获取 UTC 时间戳 System.out.println("UTC Instant from Tokyo ZonedDateTime: " + utcInstant);
// 3. 与旧版 java.util.Date 的转换
// java.time -> java.util.Date Instant instantToConvert = currentDateTime.toInstant(ZoneOffset.UTC); // 将 LocalDateTime 转换为 Instant,指定UTC偏移量 Date dateFromInstant = Date.from(instantToConvert); // 将 Instant 转换为 Date System.out.println("Date from Instant: " + dateFromInstant);
// java.util.Date -> java.time Date oldDate = new Date(); // 旧版Date对象 Instant instantFromDate = oldDate.toInstant(); // 将 Date 转换为 Instant LocalDateTime dateTimeFromOldDate = LocalDateTime.ofInstant(instantFromDate, ZoneId.systemDefault()); // 将 Instant 转换为 LocalDateTime,使用系统默认时区 System.out.println("LocalDateTime from Date: " + dateTimeFromOldDate); }}java.util.date(传统会用)
- Date(): 创建一个表示当前日期和时间的 Date 对象。
- Date(long date): 创建一个表示指定毫秒数的 Date 对象。 毫秒数是从 1970 年 1 月 1 日 00:00:00 GMT 开始计算的。
- getTime(): 返回 Date 对象表示的毫秒数。
- setTime(long time): 设置 Date 对象表示的毫秒数。
- before(Date when): 判断当前 Date 对象是否在指定日期之前。
- after(Date when): 判断当前 Date 对象是否在指定日期之后。
- equals(Object obj): 判断两个 Date 对象是否相等。
- compareTo(Date anotherDate): 比较两个 Date 对象的时间先后顺序。
- toString(): 将 Date 对象转换为字符串表示,格式取决于本地设置。 不推荐依赖此方法进行格式化,因为它依赖于本地设置,可能导致不一致的结果。
格式化注解
-
@JsonFormat: 主要用于控制序列化和反序列化日期时间的格式。它是由 Jackson 库提供的注解,通常用于将 Java 对象转换为 JSON 格式,或将 JSON 格式转换为 Java 对象。
@JsonFormat(pattern = "yyyy-MM-dd HH:mm:ss", timezone = "GMT+8")private Date registerTime; // 或 java.time 类型,例如 LocalDateTime- pattern: 指定日期时间的格式。
- timezone: 指定时区。 如果不指定,则使用系统默认时区。 “GMT+8” 等同于 “Asia/Shanghai”。
-
@DateTimeFormat: 主要用于控制 Spring MVC 在绑定请求参数到 Java 对象时,日期时间的解析格式。 它是由 Spring 框架提供的注解。
@DateTimeFormat(pattern = "yyyy-MM-dd HH:mm:ss")private Date registerTime; // 或 java.time 类型,例如 LocalDateTime- pattern: 指定日期时间的格式。 注意,这里不需要指定时区,Spring 会自动处理。
4.Java Arrays
-
1. Arrays.asList(T… a)
-
功能: 将一个数组转换为一个 List 集合。
-
语法: public static <T> List<T> asList(T… a)
-
说明:
- T… a 是一个可变参数,允许传入任意数量的相同类型的参数,会被自动封装成一个数组。
- 返回的是 Arrays 类内部的一个静态内部类 ArrayList 的实例,注意不是 java.util.ArrayList。
- 这个内部类 ArrayList 没有实现 add 和 remove 方法,因此不能直接对返回的 List 进行添加或删除操作,否则会抛出 UnsupportedOperationException 异常。
- 返回的 List 是 数组的视图,对 List 的修改会反映到原始数组上。
-
示例:
String[] arr = {"A", "B", "C"};List<String> list = Arrays.asList(arr);System.out.println(list); // 输出: [A, B, C]// 尝试添加元素会抛出异常// list.add("D"); // UnsupportedOperationException// 修改 List 会影响原数组list.set(0, "X");System.out.println(Arrays.toString(arr)); // 输出: [X, B, C]- 适用场景: 将数组转换为 List,方便使用 List 的方法进行遍历、查找等操作。 但需要注意返回的 List 的特殊性,避免进行修改操作。
2. Arrays.stream(T[] array) / Arrays.stream(int[] array) / Arrays.stream(long[] array) / Arrays.stream(double[] array)
-
功能: 将一个数组转换为一个 Stream 流。
-
语法:
- public static <T> Stream<T> stream(T[] array) (适用于对象数组)
- public static IntStream stream(int[] array) (适用于 int 数组)
- public static LongStream stream(long[] array) (适用于 long 数组)
- public static DoubleStream stream(double[] array) (适用于 double 数组)
-
说明:
- 针对不同类型的数组,提供了不同的 stream 方法,返回对应的 Stream 类型。 IntStream、LongStream 和 DoubleStream 分别是针对基本类型 int、long 和 double 的特殊 Stream,提供了更高效的操作。
- 可以将数组转换为 Stream 流,从而可以使用 Stream API 进行各种复杂的过滤、映射、排序、聚合等操作。
-
示例:
int[] numbers = {1, 2, 3, 4, 5};// 将 int 数组转换为 IntStream,然后进行过滤和求和操作int sum = Arrays.stream(numbers).filter(n -> n % 2 == 0) // 过滤偶数.sum(); // 求和System.out.println("偶数之和: " + sum); // 输出: 偶数之和: 6String[] names = {"Alice", "Bob", "Charlie"};// 将 String 数组转换为 Stream<String>,然后进行映射和收集操作List<String> upperCaseNames = Arrays.stream(names).map(String::toUpperCase) // 转换为大写.collect(Collectors.toList()); // 收集到 ListSystem.out.println(upperCaseNames); // 输出: [ALICE, BOB, CHARLIE]- 适用场景: 需要对数组进行复杂的数据处理,例如过滤、映射、排序、聚合等操作时,转换为 Stream 流可以充分利用 Stream API 的强大功能。
3. Arrays.sort(T[] a) / Arrays.sort(int[] a) / Arrays.sort(long[] a) / Arrays.sort(double[] a) 等重载方法
-
功能: 对数组进行排序。
-
语法: 提供了多种重载方法,可以对不同类型的数组进行排序,可以指定排序范围,也可以传入自定义的 Comparator 进行排序。
- public static void sort(int[] a) (对整个 int 数组进行升序排序)
- public static void sort(int[] a, int fromIndex, int toIndex) (对 int 数组指定范围进行升序排序)
- public static <T> void sort(T[] a, Comparator<? super T> c) (对对象数组使用自定义 Comparator 进行排序)
-
说明:
- 对于基本类型数组,默认进行升序排序。
- 对于对象数组,需要实现 Comparable 接口,或者传入自定义的 Comparator。
- fromIndex(包含)和 toIndex(不包含)指定了排序的范围。
- Arrays.sort() 使用了高效的排序算法(例如 Dual-Pivot Quicksort)。
-
示例:
int[] numbers = {5, 2, 8, 1, 9};Arrays.sort(numbers);System.out.println(Arrays.toString(numbers)); // 输出: [1, 2, 5, 8, 9]String[] names = {"Charlie", "Alice", "Bob"};Arrays.sort(names, (s1, s2) -> s1.compareToIgnoreCase(s2)); // 忽略大小写排序System.out.println(Arrays.toString(names)); // 输出: [Alice, Bob, Charlie]int[] subArray = {5, 2, 8, 1, 9};Arrays.sort(subArray, 1, 4); // 对索引 1 到 3 (不包括 4) 的元素进行排序System.out.println(Arrays.toString(subArray)); // 输出: [5, 1, 2, 8, 9]- 适用场景: 需要对数组进行排序时,可以使用 Arrays.sort() 方法。 可以使用默认的升序排序,也可以自定义排序规则。
4. Arrays.binarySearch(T[] a, T key) / Arrays.binarySearch(int[] a, int key) / Arrays.binarySearch(long[] a, long key) / Arrays.binarySearch(double[] a, double key) 等重载方法
-
功能: 在排序后的数组中查找指定元素的索引。
-
语法:
- public static int binarySearch(int[] a, int key) (在 int 数组中查找 key)
- public static <T> int binarySearch(T[] a, T key) (在对象数组中查找 key)
- public static int binarySearch(int[] a, int fromIndex, int toIndex, int key) (在 int 数组的指定范围内查找 key)
-
说明:
- 前提条件:数组必须已经排序。
- 如果找到 key,则返回其索引。
- 如果未找到 key,则返回 -(insertion point) - 1,其中 insertion point 是 key 应该插入的位置(保持排序)。
- 如果数组包含多个与 key 相等的元素,则不保证返回哪个元素的索引。
- fromIndex(包含)和 toIndex(不包含)指定了查找的范围。
-
示例:
int[] numbers = {1, 2, 5, 8, 9};int index = Arrays.binarySearch(numbers, 5);System.out.println("5 的索引: " + index); // 输出: 5 的索引: 2int index2 = Arrays.binarySearch(numbers, 3);System.out.println("3 的索引: " + index2); // 输出: 3 的索引: -3 (表示应该插入到索引 2 的位置)String[] names = {"Alice", "Bob", "Charlie"};Arrays.sort(names); // 必须先排序int index3 = Arrays.binarySearch(names, "Bob");System.out.println("Bob 的索引: " + index3); // 输出: Bob 的索引: 1- 适用场景: 需要在排序后的数组中快速查找指定元素时,可以使用 Arrays.binarySearch() 方法。
-
2024/11/26
1.mybatis(动态sql)
-
核心关键字:
- select: 定义查询语句,用于从数据库检索数据。
- insert: 定义插入语句,用于向数据库添加新记录。
- update: 定义更新语句,用于修改数据库中的现有记录。
- delete: 定义删除语句,用于从数据库中删除记录。
动态 SQL 相关关键字 (非常重要):
- if: 根据条件执行 SQL 片段。 常与test结合使用判断
- choose / when / otherwise: 类似于 Java 中的 switch 语句,用于多条件选择。
- ==trim / where / set====: 用于去除 SQL 语句中多余的关键字或字符,例如避免 where 条件为空时出现 “WHERE AND” 的情况. where 会自动处理第一个 and 或 or,set 会自动处理最后一个逗号。==
- foreach: 遍历集合,用于构建 IN 条件或批量操作。
- bind: 创建一个变量并将其绑定到一个值。
参数和结果映射:
- parameterType: 指定输入参数的类型。 在 MyBatis 3.4.0 之后,通常可以省略,MyBatis 会自动推断类型。 ==@Param(“bean”) 注入参数并命名==
- resultMap: 定义结果集与 Java 对象之间的映射关系。
- resultType: 指定结果的类型,适用于简单的查询结果。 在 MyBatis 3.4.0 之后,通常可以省略,MyBatis 会自动推断类型。
其他常用关键字:
- sql: 定义可重用的 SQL 片段。
- include: 引入已定义的 SQL 片段。
- resultMap: 定义结果集与 Java 对象之间的映射关系,可以处理复杂的映射场景。
- collection / association: 用于处理一对多和一对一关系的嵌套查询。
- discriminator / case: 用于处理继承关系的映射。
INSERT INTO email_code <trim prefix="(" suffix=")" suffixOverrides=","> <if test="bean.email != null"> email, </if> <if test="bean.code != null"> code, </if> <if test="bean.createTime != null"> create_time, </if> <if test="bean.status != null"> status, </if> </trim><trim prefix=”(” suffix=”)” suffixOverrides=”,”> 的作用是动态构建 INSERT 语句中列名的部分,并确保 SQL 语法正确,==即使某些字段为空也不会出现多余的逗号。 它通过 prefix 和 suffix 添加括号,通过 suffixOverrides 去除最后一个逗号。==
2.MyBatis 传入参数的问题
对于传入参数的指定常用parameterType 一般基本数据类型会自动映射不需要指定,对于复杂数据类型,例如对象,集合需要指定。
对于返回类型使用resultType/resultMap,同样基本数据类型可以不指定,对于复杂数据类型需要。
@Param注解
== 对于@Param注解的使用,一般如果使用了该注解传参,那么在xml中就不再需要parameterType声明==
-
MyBatis 如何处理多个参数? 在 MyBatis 中,==如果一个 Mapper 方法只有一个参数,MyBatis 默认会将这个参数当作 parameter== 传递给 SQL 语句,我们可以在 SQL 中直接引用它。==但当有多个参数时,MyBatis 会把它们封装成一个 Map 对象==,参数名是系统生成的,形式类似于 param1、param2 等。
例如,如果我们有一个方法如下: List<RadiatedAreaVo> getScanAreaLine(String startDate, String endDate);
-
MyBatis 会默认地将参数封装成:{param1=startDateValue, param2=endDateValue} 这时,在 XML 中引用参数时,就必须通过 #{param1} 和 #{param2} 来访问这两个参数。
如果想要在 SQL 中明确使用自己定义的名字而不是 param1、param2,那么就需要使用 @Param 注解了。我们可以通过 @Param 明确指定每个参数的名称。
例如:
List<RadiatedAreaVo> getScanAreaLine(@Param(“startDate”) String startDate, @Param(“endDate”) String endDate); MyBatis 会将参数封装成:=={startDate=startDateValue, endDate=endDateValue}== 现在,我们就可以在 SQL 中通过 #{startDate} 和 #{endDate} 访问这些参数。
一、单个参数
-
基本数据类型
-
不使用注解:当只有一个基本类型的参数时,可以直接在
#{}中使用参数名,MyBatis 会自动识别。List<ChargeRuleDO> tests(long id);<select resultType="com.xxx.bean.ChargeRuleDO">select * from t_charge_rule t where t.id = #{id}</select> -
使用 @Param 注解:当需要明确指定参数名时,可以在方法参数前加上
@Param注解。List<ChargeRuleDO> tests(@Param("aid") long bid);<select resultType="com.xxx.bean.ChargeRuleDO">select * from t_charge_rule t where t.id = #{aid}</select>
-
-
复杂数据类型(Java 实体类)
-
不使用注解:如果传递的是一个实体对象,可以直接在
#{}中使用对象的属性名。List<ChargeRuleDO> tests(TestQO testQO);<select resultType="com.xxx.bean.ChargeRuleDO">select * from t_charge_rule t where t.id = #{id} and t.rule_type=#{ruleType}</select> -
使用 @Param 注解:如果使用了
@Param注解,需要在#{}中指定对象的完整路径。List<ChargeRuleDO> tests(@Param("atestQO") TestQO btestQO);<select resultType="com.xxx.bean.ChargeRuleDO">select * from t_charge_rule t where t.id = #{atestQO.id} and t.rule_type=#{atestQO.ruleType}</select>
-
二、多个参数
-
基本数据类型
-
不使用注解:可以通过位置参数(如
#{0},#{1})来引用参数。List<ChargeRuleDO> tests(long id, String ruleType);<select resultType="com.xxx.bean.ChargeRuleDO">select * from t_charge_rule t where t.id = #{0} and t.rule_type=#{1}</select> -
==使用 @Param 注解====:推荐使用 ====
@Param==== 注解来明确指定每个参数的名称。==List<ChargeRuleDO> tests(@Param("id") long id, @Param("ruleType") String ruleType);<select resultType="com.xxx.bean.ChargeRuleDO">select * from t_charge_rule t where t.id = #{id} and t.rule_type=#{ruleType}</select>
-
-
复杂数据类型
-
不使用注解:直接传递多个对象时,可能需要额外处理,因为 MyBatis 默认情况下不支持直接传递多个对象。
-
==使用 @Param 注解====:使用 ====
@Param==== 注解来明确指定每个对象的名称,并在 ====#{}==== 中使用完整的路径。==List<ChargeRuleDO> tests(@Param("testQO") TestQO testQO, @Param("testQO2") TestQO2 testQO2);<select resultType="com.xxx.bean.ChargeRuleDO">select * from t_charge_rule t where t.id = #{testQO.id} and t.rule_type=#{testQO.ruleType} and t.user_id=#{testQO2.uesrId}</select>
-
-
基本数据类型与复杂数据类型混合使用
- 使用 @Param 注解:基本数据类型可以直接使用,复杂数据类型需要使用
@Param注解。List<ChargeRuleDO> tests(long id, String ruleType, @Param("testQO2") TestQO2 testQO2);<select resultType="com.xxx.bean.ChargeRuleDO">select * from t_charge_rule t where t.id = #{0} and t.rule_type=#{1} and t.user_id=#{testQO2.uesrId}</select>
- 使用 @Param 注解:基本数据类型可以直接使用,复杂数据类型需要使用
三、List 参数
- 传递 List 类型参数:使用
<foreach>标签来遍历列表。List<ChargeRuleDO> tests(List<Long> list);<select resultType="com.xxx.bean.ChargeRuleDO">select * from t_charge_rule t where t.id in<foreach item="item" index="index" collection="list" open="(" separator="," close=")">#{item}</foreach></select>
四、Map 参数
- 传递 Map 类型参数:使用
<foreach>标签遍历 Map,并通过key和value访问 Map 的键值对。int updateInventoryBatch(@Param("inventoryMap") HashMap<String, Integer> inventoryMap);<update parameterType="java.util.Map"><foreach item="value" index="key" collection="inventoryMap" separator=";">UPDATE yanxuan_inventory_transferSETinventory = #{value},is_inventory='1',create_time=sysdate()WHEREsku_id=#{key}</foreach></update>
2024/11/29
1.序列化
==序列化==是==将对象的状态信息转换为可以存储或传输的形式的过程==。==反序列化==则是将==存储或传输形式的数据==转换回==对象==的过程。
- 数据持久化: 将对象的状态保存到磁盘或数据库中,以便以后恢复。
- 数据传输: 通过网络传输对象的数据,例如在 Web 服务或分布式系统中。
- 缓存: 将对象的状态存储在缓存中,以提高访问速度。
- 深度拷贝: 创建对象的副本,包括对象内部的嵌套对象。
各种序列化方式的比较:
-
二进制序列化:
- 优点:速度快,体积小。
- 缺点:可读性差,不同语言或平台之间难以兼容。
-
JSON 序列化:
- 优点:可读性好,跨语言兼容性好,体积相对较小。
- 缺点:速度略慢于二进制序列化。
-
XML 序列化:
- 优点:可读性好,可扩展性强。
- 缺点:体积较大,速度较慢。
//Serializable 接口:// Serializable 接口是 Java 中用于序列化对象的接口。实现 Serializable 接口的类可以被序列化,这意味着可以将对象转换为字节流,并将其写入文件或网络流中。反序列化则可以将字节流恢复为对象。
/** 一般什么时候需要使用序列化呢?* 将对象写入数据库(mysql,redis等)或其在网络传输中,另一端是不能理解对象的复杂结构的,* 他们一般智能理解字符串(一般文本,json,xml等)因此需要将对象进行序列化处理* 如果我只是单一的对象与数据库对应,不需要对对象进行传输则不需要序列化操作。** 注意,在前后端开发中,后端我们这里使用springboot框架Spring Boot 内置了 Spring MVC 框架,Spring MVC 提供了强大的 RESTful API 开发支持,* 并集成了 Jackson 库,默认使用 JSON 作为数据格式进行序列化和反序列化。*/==Spring Boot 可以自动将前端传递的 JSON 字符串反序列化为 Java 对象。 例如:==
- @RequestBody 注解: 在 Controller 方法的参数上使用 @RequestBody 注解,表明该参数需要从请求体中获取数据。 #此处详细介绍在参数接收
- HttpMessageConverter: Spring Boot 使用 HttpMessageConverter 来处理请求和响应的数据转换。当请求的 Content-Type 为 application/json 时,Spring Boot 会自动使用 MappingJackson2HttpMessageConverter(如果 Jackson 依赖存在于 classpath 中)将 JSON 字符串反序列化为 Java 对象。
- Jackson 库: Jackson 是 Spring Boot 默认使用的 JSON 处理库。它负责将 JSON 字符串解析成 Java 对象,以及将 Java 对象序列化成 JSON 字符串。
2.java泛型
在 Java 泛型中,V、P 和 T 都是常用的类型参数名称,但它们各自通常代表不同的含义。这些字母并没有固定的语义,而是根据上下文和开发者的选择来定义的。
T (Type):通常用来表示任意类型的对象。这是最通用的类型参数,当你不需要指定具体的类型时可以使用它。 V (Value):常用于表示值类型,尤其是在键值对(如 Map)中,V 代表值的类型。 P (Parameter):有时用于表示方法参数的类型,或者在某些情况下,可能表示生产者(Producer)的类型。
使用 V 表示值类型import java.util.Map;import java.util.HashMap;
public class RedisUtils<V> { private final Map<String, V> cache = new HashMap<>();
public void set(String key, V value) { cache.put(key, value); }
public V get(String key) { return cache.get(key); }}在这个例子中,V 代表 Redis 缓存中存储的值的类型。使用 T 表示通用类型public class Box<T> { private T content;
public void setContent(T content) { this.content = content; }
public T getContent() { return content; }}这里 T 是一个通用类型参数,可以是任何类型,比如 Integer、String 或自定义的对象。使用 P 表示参数类型
public class Processor {public void process(P parameter) {// 处理参数的逻辑}}在这个例子中,P 代表处理器方法接受的参数类型。组合使用多个类型参数你也可以在一个类或方法中同时使用多个泛型参数。例如,如果你有一个方法需要处理键值对,并且键和值的类型不同。public class KeyValueProcessor<K, V> {private final Map<K, V> data = new HashMap<>();public void put(K key, V value) { data.put(key, value);}
public V get(K key) { return data.get(key);}}在这里,K 代表键的类型,而 V 代表值的类型。泛型方法示例你还可以为单个方法定义类型参数,而不必在整个类上使用泛型。这使得方法可以在不改变类的情况下支持多种类型。public class Util {
// 泛型方法,T 作为类型参数public static <T> void printArray(T[] array) { for (T element : array) { System.out.println(element); }}
// 泛型方法,P 作为参数类型public static <P> void process(P parameter) { // 处理参数的逻辑 System.out.println("Processing: " + parameter);}}2024/11/30
1. equals 与 ==
/* 字符串常量池: Java 中有一个字符串常量池,用来存储字符串常量。当程序创建字符串常量时,如果字符串常量池中已经存在该字符串,则不会创建新的对象,而是返回指向常量池中该字符串的引用。*/
/* String str1 = "Hello"; String str2 = "Hello"; String str3 = new String("Hello");
System.out.println(str1 == str2); // true 因为 str1 和 str2 指向同一个字符串常量池中的 "Hello" 对象System.out.println(str1 == str3); // false 因为 str3 创建了一个新的字符串对象System.out.println(str1.equals(str2)); // true 因为 str1 和 str2 的内容相同System.out.println(str1.equals(str3)); // true 因为 str1 和 str3 的内容相同*/2.instanceof
instanceof 是 Java 中的一个关键字,用于在运行时检查对象是否是指定类型或其子类的实例。
public Long getFileSizeFromRedis(String key) { //从redis中获取名为key的键值 Object object = redisUtils.get(key);
//如果redis中没有返回0L if (null == object) { return 0L; } //TODO instanceof //如果返回的键值类型为Integer,则转化为Long类型 if (object instanceof Integer) { return ((Integer) object).longValue(); } //如果类型为Long,直接返回 else if (object instanceof Long) { return (Long) object; }
//否则返回0L return 0L;
}2024/12/4
1.后端如何接收前端的参数
当与前端交互的过程当中,常用json数据与前端进行交互,这样想取出前端传送过来的json数据的时候,我们常有以下几种方式:
-
1. 无注解传参
- 适用场景: 简单参数,参数名与请求参数名一致。
- 原理: Spring 会根据方法参数名与请求参数名进行匹配。
- 局限性: 仅适用于参数名完全匹配的情况,灵活性较差。==如果参数名不匹配或需要处理复杂对象,则无法使用==。
@GetMapping("/users")public List<User> getUsers(String name, int age) {// ...}2. @PathVariable
- 适用场景: 获取 URL 路径中的参数。
- 原理: ==从 URL 模板中提取参数值==。
- 示例:
@GetMapping("/users/{id}")public User getUser(@PathVariable Long id) {// ...}3. @RequestParam
-
适用场景: ==获取请求参数(查询参数或表单参数)==。
-
原理: 从请求参数中提取值,可以处理多个参数。
-
特性:
- required 属性:指定参数是否必需。
- defaultValue 属性:设置参数的默认值。
-
示例:
@GetMapping("/users")public List<User> getUsers(@RequestParam(required = false) String name,@RequestParam(defaultValue = "10") int pageSize) {// ...}4. @RequestBody
- 适用场景: ==接收请求体中的数据==,通常用于处理 JSON 或 XML 格式的数据。
- 原理: 使用 HttpMessageConverter 将请求体数据反序列化为 Java 对象。
- 示例:
@PostMapping("/users")public User createUser(@RequestBody User user) {// ...}5. 其他参数类型
除了以上几种方式,Spring Boot 还支持其他一些参数类型:
- MultipartFile: 用于处理文件上传。
- HttpHeaders: 用于访问 HTTP 请求头信息。
- HttpEntity<T>: 包含请求头和请求体的泛型类型。
- Map<String, String> 或 MultiValueMap<String, String>: 用于接收所有请求参数。
- HttpServletRequest、HttpServletResponse、HttpSession: 用于访问 Servlet API。 (尽量避免直接使用,推荐使用更高级的抽象)
虽然Java Servlet可以满足需求,但在springboot中可以使用更高级的抽象1. 更高级的抽象及其使用示例:获取请求参数: 使用 @RequestParam、@PathVariable、@ModelAttribute 等注解,而不是 HttpServletRequest.getParameter()。@GetMapping("/users")public String getUsers(@RequestParam String name, @PathVariable Long id) {// ...}设置响应头: 使用 ResponseEntity 或 @ResponseStatus 注解,而不是 HttpServletResponse.setHeader()。@GetMapping("/users/{id}")public ResponseEntity<User> getUser(@PathVariable Long id) {User user = userService.findById(id);return ResponseEntity.ok().header("X-Custom-Header", "someValue").body(user);}重定向: 使用 RedirectView、ModelAndView 或 @RedirectAttributes,而不是 HttpServletResponse.sendRedirect()。@PostMapping("/users")public ModelAndView createUser(@ModelAttribute User user, RedirectAttributes redirectAttributes) {userService.save(user);redirectAttributes.addFlashAttribute("message", "User created successfully!"); // 添加 Flash Attributereturn new ModelAndView("redirect:/users");}访问请求体: 使用 @RequestBody,而不是直接读取 HttpServletRequest 的输入流。@PostMapping("/users")public void createUser(@RequestBody User user) {// ...}2.对于session的操控添加依赖:<dependency><groupId>org.springframework.session</groupId><artifactId>spring-session-data-redis</artifactId></dependency><dependency><groupId>org.springframework.boot</groupId><artifactId>spring-boot-starter-data-redis</artifactId></dependency>Xml配置 Redis 连接信息 (例如在 application.properties 中):spring.redis.host=localhostspring.redis.port=6379Properties启用 Spring Session:@EnableRedisHttpSessionpublic class Config {// ... other configurations}使用 Session 或 MapSession 访问 Session:@GetMapping("/users")public String getUsers(Session session) { // 或 MapSession sessionsession.setAttribute("userName", "John");// ...}
6. 前端 params 和 data 对应后端的接收方式总结
| 前端方式 | 后端接收方式 | 示例 |
|---|---|---|
params | @RequestParam | @RequestParam String keyword |
data | @RequestBody(推荐) | @RequestBody UserDTO user |
data | @RequestParam(form-urlencoded) | @RequestParam String username |
** 说明**:
-
@RequestParam:-
必需参数:默认是必需的,如果参数缺失会抛出异常。
-
可选参数:可以通过
required = false设置为可选,并指定默认值defaultValue。@RequestParam(required = false, defaultValue = "1") int page
-
说明:
-
@RequestBody:- 自动将请求体(JSON)反序列化为 Java 对象。
- 必须确保请求头
Content-Type: application/json。
2.后端返回数据给前端
1.返回 JSON 数据 (最常用)
-
适用场景: 前后端分离的 Web 应用、RESTful API。
依靠 Spring Boot 内置的 HttpMessageConverter 机制,特别是 MappingJackson2HttpMessageConverter 引入依赖
-
方法: 使用 @ResponseBody 注解或 ResponseEntity 对象。
-
优点: 轻量级、易于解析、跨平台兼容性好。
-
示例:
-
@ResponseBody 注解:
- 作用: @ResponseBody 注解告诉 Spring Boot 将方法的返回值直接写入 HTTP 响应体,而不是作为视图名称解析。
- 适用场景: 适合简单的 RESTful API,只需要返回数据,不需要设置 HTTP 状态码或自定义响应头。
- 示例:
@GetMapping("/users")@ResponseBodypublic List<User> getUsers() {List<User> users = userService.findAll();return users; // userList 会被自动序列化为 JSON 数组}getUsers() 方法返回一个 List<User> 对象。@ResponseBody 注解会使 Spring Boot 使用 Jackson 将 users 列表序列化为 JSON 数组,并将其写入 HTTP 响应体。
ResponseEntity 对象:
- 作用: ResponseEntity 对象代表整个 HTTP 响应,包括状态码、响应头和响应体。它提供了更精细的控制,可以自定义 HTTP 响应的各个方面。
- 适用场景: 适合需要设置 HTTP 状态码、自定义响应头或处理不同响应类型的场景。
- 示例:
@GetMapping("/users/{id}")public ResponseEntity<User> getUser(@PathVariable Long id) {Optional<User> userOptional = userService.findById(id);if (userOptional.isPresent()) {User user = userOptional.get();return ResponseEntity.ok(user); // 返回 200 OK 和 User 对象的 JSON 数据} else {return ResponseEntity.notFound().build(); // 返回 404 Not Found}}getUser() 方法返回一个 ResponseEntity<User> 对象。ResponseEntity.ok(user) 会创建一个状态码为 200 OK 的 ResponseEntity,并将 user 对象作为响应体。 ResponseEntity.notFound().build() 则创建一个状态码为 404 Not Found 的 ResponseEntity,没有响应体。
ResponseEntity 的常用方法:
- ==ok(): 创建 200 OK 响应。==
- created(URI location): 创建 201 Created 响应,并设置 Location 头部信息。
- accepted(): 创建 202 Accepted 响应。
- ==badRequest(): 创建 400 Bad Request 响应。==
- ==notFound(): 创建 404 Not Found 响应。==
- status(HttpStatus status): 创建自定义状态码的响应。
- headers(HttpHeaders headers): 设置响应头。
- body(T body): 设置响应体。
2.自定义返回体,或直接返回,引入Jackson后springboot回自动实现序列化。
3.前端如何发送/接收后端的数据
使用 Axios (第三方库)
Axios 是一个流行的基于 Promise 的 HTTP 客户端,它简化了网络请求的发送和处理。
- 发送 GET 请求:
axios.get('/users') .then(response => { console.log(response.data); // 数据直接在 response.data 中 }) .catch(error => { console.error(error); });- 发送 POST 请求:
axios.post('/users', { name: 'John', age: 30 }) .then(response => { console.log(response.data); }) .catch(error => { console.error(error); });(1)params
-
定义:
params是用于配置 查询参数,它会将参数附加到 URL 的末尾,以查询字符串的形式发送。 -
使用场景:适用于 GET 请求 或需要在 URL 中显示参数的场景。
-
数据形式:参数会以
key=value的形式出现在 URL 中。 -
示例:
axios.get('/api/users', {params: { id: 123, name: 'John' }});请求 URL:
/api/users?id=123&name=John
(2)data
-
定义:
data是用于发送请求体中的数据,主要用于 POST、PUT、PATCH 等非 GET 请求。 -
使用场景:适用于发送大规模或敏感数据(如表单数据、JSON 对象)时,不希望参数暴露在 URL 中。
-
数据形式:参数会包含在请求体(Body)中,而不会出现在 URL。
-
示例:
axios.post('/api/users', {data: { id: 123, name: 'John' }});请求 URL:
bash复制代码/api/users请求体:
{"id": 123,"name": "John"}
(3)主要区别总结
| 特性 | params | data |
|---|---|---|
| 发送方式 | 附加在 URL 上 | 包含在请求体(Body)中 |
| 适用方法 | GET 请求为主 | POST、PUT、PATCH、DELETE 等 |
| 参数暴露性 | 参数会暴露在 URL 中 | 参数不会暴露,适合发送敏感信息 |
| 数据大小 | 适合较小的数据(如过滤条件) | 适合较大的复杂数据(如 JSON) |
| 浏览器缓存 | 因为在 URL 中,可能被浏览器缓存 | 不会被缓存 |
params:查询条件、分页信息、过滤参数等,可以放在 URL 中。data:涉及敏感信息(如密码)或需要传递复杂数据时,建议使用data。
2024/12/9
1.java IO
File类
-
java.io.File类是专门对文件进行操作的类,==只能对文件本身进行操作,不能对文件内容进行操作==。
java.io.File类==是文件和目录路径名的抽象表示,主要用于文件和目录的创建、查找和删除等操作==。File类构造方法不会给你检验这个文件或文件夹是否真实存在,==因此无论该路径下是否存在文件或者目录,都不影响File对象的创建。==
-
1.构造函数
-
==public File(String pathne)==
String path = "D:\\123.txt"; File file1 = new File(path); -
2.获取功能的方法
public String getAbsolutePath():返回此File的绝对路径名字符串。public String getPath():将此File转换为路径名字符串。public String getName():返回由此File表示的文件或目录的名称。public long length():返回由此File表示的文件的长度。public class FileGet {public static void main(String[] args) {File f = new File("d:/aaa/bbb.java");System.out.println("文件绝对路径:"+f.getAbsolutePath());System.out.println("文件构造路径:"+f.getPath());System.out.println("文件名称:"+f.getName());System.out.println("文件长度:"+f.length()+"字节");File f2 = new File("d:/aaa");System.out.println("目录绝对路径:"+f2.getAbsolutePath());System.out.println("目录构造路径:"+f2.getPath());System.out.println("目录名称:"+f2.getName());System.out.println("目录长度:"+f2.length());}}输出结果:文件绝对路径:d:\aaa\bbb.java文件构造路径:d:\aaa\bbb.java文件名称:bbb.java文件长度:2116字节目录绝对路径:d:\aaa目录构造路径:d:\aaa目录名称:aaa目录长度:3236注意:
length(),表示文件的长度。但是File对象表示目录,则返回值未指定。- 3. 绝对路径和相对路径
绝对路径:一个完整的路径,以盘符开头,例如
F://aaa.txt。
相对路径:一个简化的路径,不以盘符开头,例如//aaa.txt//b.txt。1、路径是不区分大小写
2、路径中的文件名称分隔符windows使用反斜杠,反斜杠是转义字符,两个反斜杠代表一个普通的反斜杠//绝对路径public class FilePath {public static void main(String[] args) {// D盘下的bbb.java文件File f = new File("D:\\bbb.java");System.out.println(f.getAbsolutePath());// 项目下的bbb.java文件File f2 = new File("bbb.java");System.out.println(f2.getAbsolutePath());}}输出结果:D:\bbb.javaD:\java\bbb.java- 4.判断功能的方法
1、
public boolean exists():此File表示的文件或目录是否实际存在。
2、public boolean isDirectory():此File表示的是否为目录。
3、public boolean isFile():此File表示的是否为文件。方法演示,代码如下:
public class FileIs {public static void main(String[] args) {File f = new File("d:\\aaa\\bbb.java");File f2 = new File("d:\\aaa");// 判断是否存在System.out.println("d:\\aaa\\bbb.java 是否存在:"+f.exists());System.out.println("d:\\aaa 是否存在:"+f2.exists());// 判断是文件还是目录System.out.println("d:\\aaa 文件?:"+f2.isFile());System.out.println("d:\\aaa 目录?:"+f2.isDirectory());}}输出结果:d:\aaa\bbb.java 是否存在:trued:\aaa 是否存在:trued:\aaa 文件?:falsed:\aaa 目录?:true5.创建删除功能的方法
public boolean createNewFile():文件不存在,创建一个新的空文件并返回true,文件存在,不创建文件并返回false。public boolean delete():删除由此File表示的文件或目录。public boolean mkdir():创建由此File表示的目录。public boolean mkdirs():创建由此File表示的目录,包括任何必需但不存在的父目录。
其中,
mkdirs()和mkdir()方法类似,但mkdir(),只能创建一级目录,mkdirs()可以创建多级目录比如//a//b//c,所以开发中一般用mkdirs();这些方法中值得注意的是createNewFile方法以及mkdir与mkdirs的区别
方法测试,代码如下:
public class FileCreateDelete {public static void main(String[] args) throws IOException {// 文件的创建File f = new File("aaa.txt");System.out.println("是否存在:"+f.exists()); // falseSystem.out.println("是否创建:"+f.createNewFile()); // trueSystem.out.println("是否创建:"+f.createNewFile()); // 以及创建过了所以再使用createNewFile返回falseSystem.out.println("是否存在:"+f.exists()); // true// 目录的创建File f2= new File("newDir");System.out.println("是否存在:"+f2.exists());// falseSystem.out.println("是否创建:"+f2.mkdir()); // trueSystem.out.println("是否存在:"+f2.exists());// true// 创建多级目录File f3= new File("newDira\\newDirb");System.out.println(f3.mkdir());// falseFile f4= new File("newDira\\newDirb");System.out.println(f4.mkdirs());// true// 文件的删除System.out.println(f.delete());// true// 目录的删除System.out.println(f2.delete());// trueSystem.out.println(f4.delete());// false}}注意:
delete方法,如果此File表示目录,则目录必须为空才能删除。6.目录的遍历
public String[] list():返回一个String数组,表示该File目录中的所有子文件或目录。public File[] listFiles():返回一个File数组,表示该File目录中的所有的子文件或目录。
public class FileFor {public static void main(String[] args) {File dir = new File("G:\光标");//获取当前目录下的文件以及文件夹的名称。String[] names = dir.list();for(String name : names){System.out.println(name);}//获取当前目录下的文件以及文件夹对象,只要拿到了文件对象,那么就可以获取更多信息File[] files = dir.listFiles();for (File file : files) {System.out.println(file);}}}
-
IO流
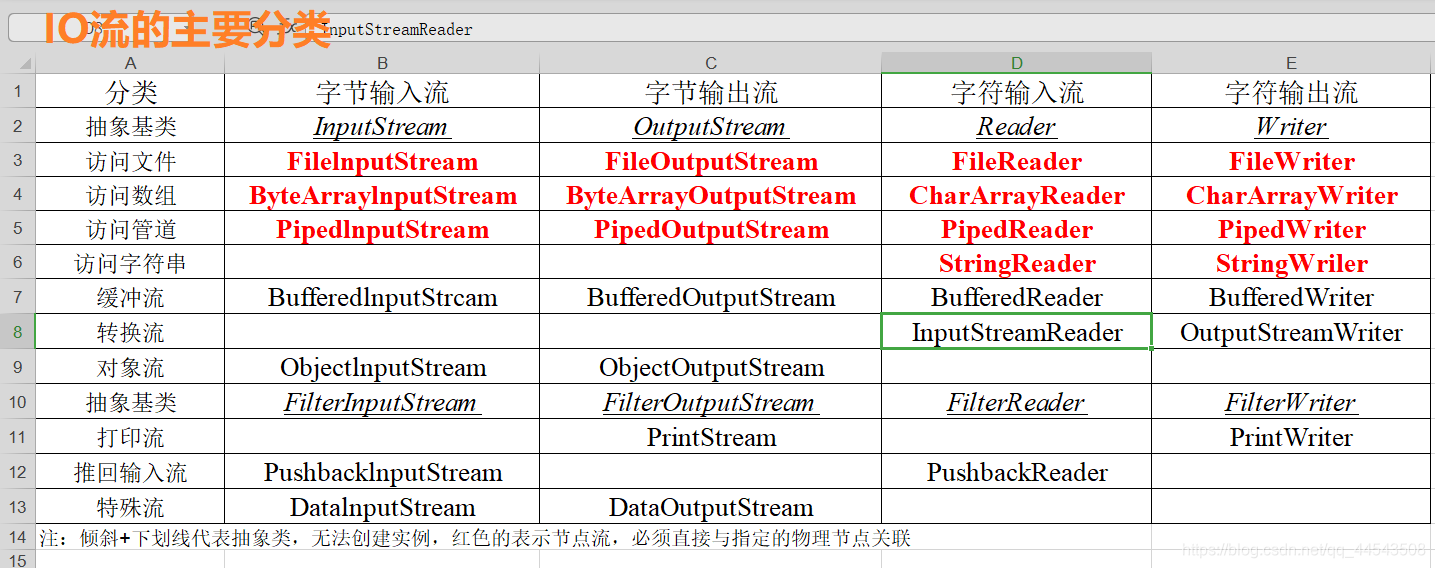
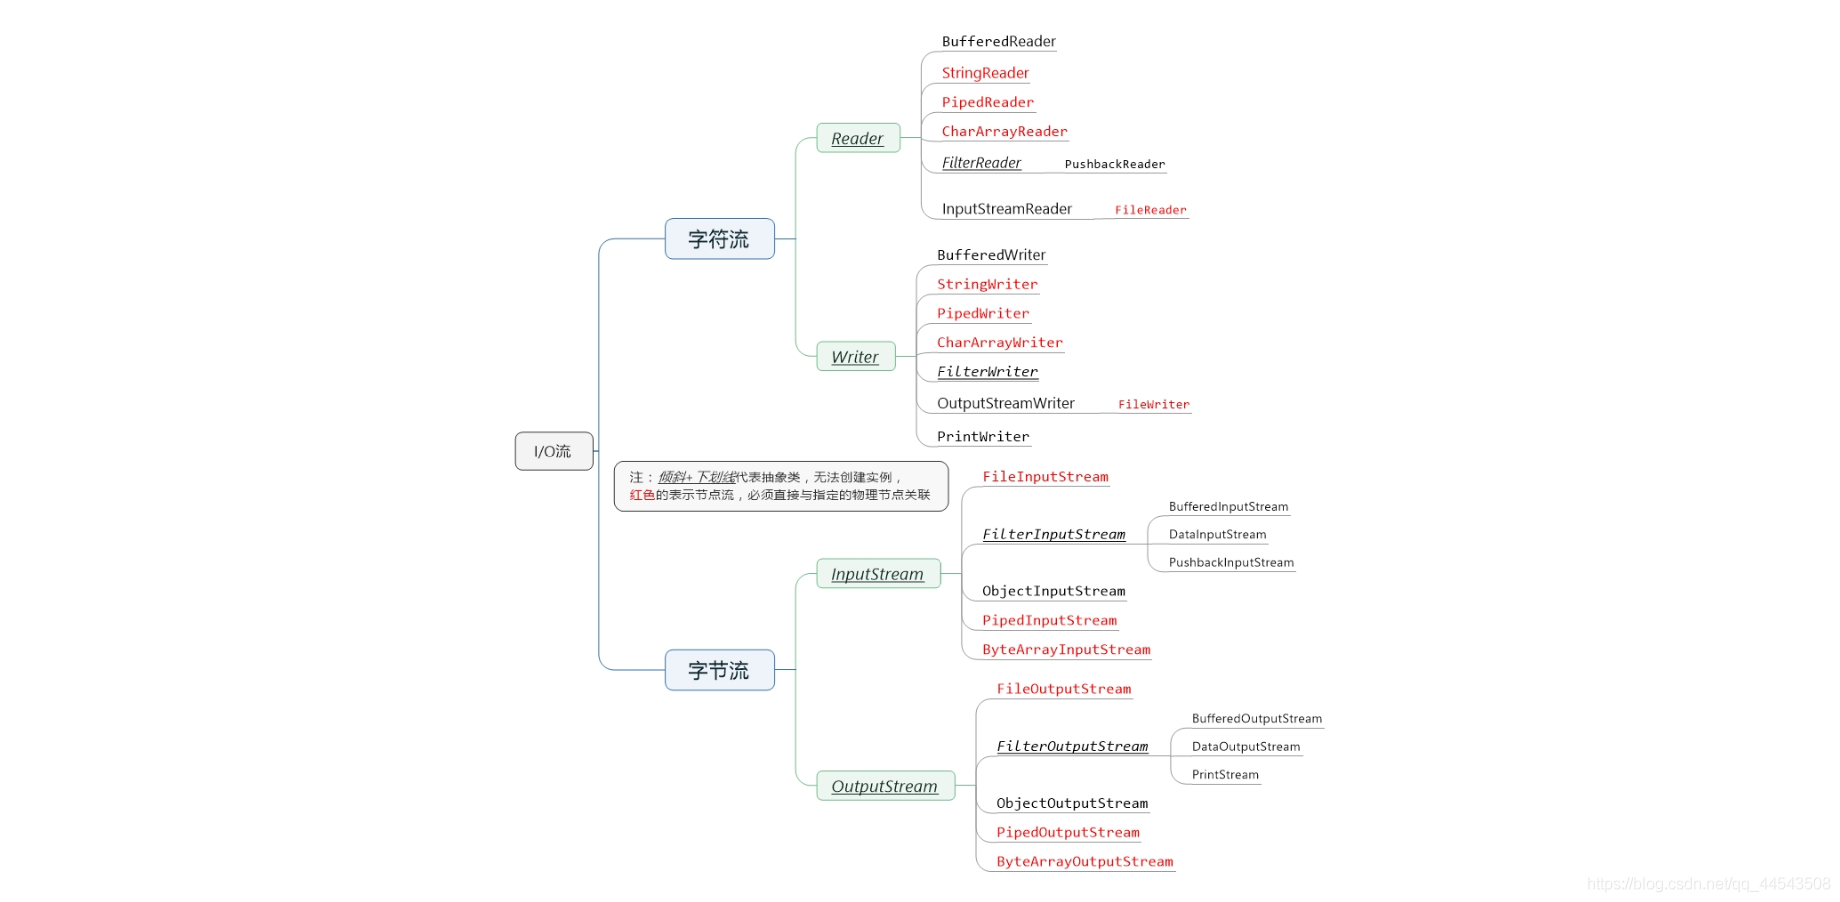
字节流:
-
FileInputStream: 从文件中读取字节数据。
- ==read(): 读取单个字节,返回读取的字节值(0-255),如果已到达文件末尾则返回 -1。==
- ==read(byte[] b): 将数据读入字节数组 b,返回读取的字节数,如果已到达文件末尾则返回 -1。==
- ==read(byte[] b, int off, int len): 将数据读入字节数组 b 的指定偏移量 off 开始的 len 个字节,返回读取的字节数==。
- available(): 返回可读取的字节数的估计值。
- ==close(): 关闭输入流,释放资源。==
-
FileOutputStream: 将字节数据写入文件。
- ==write(int b): 写入单个字节。==
- ==write(byte[] b): 写入字节数组 b 中的所有字节。==
- ==write(byte[] b, int off, int len): 写入字节数组 b 的指定偏移量 off 开始的 len 个字节。==
- ==flush(): 将缓冲区中的数据强制写入文件。==
- ==close(): 关闭输出流,释放资源。==
-
ByteArrayInputStream: 从字节数组中读取数据。
- read(), read(byte[] b), read(byte[] b, int off, int len), available(), close(): 与 FileInputStream 类似。
-
ByteArrayOutputStream: 将数据写入字节数组。
- write(int b), write(byte[] b), write(byte[] b, int off, int len), flush(), close(): 与 FileOutputStream 类似。
- ==toByteArray(): 将写入的字节数据转换为字节数组。==
- toString(): 将写入的字节数据转换为字符串(使用平台默认字符集)。
- ==toString(String charsetName): 将写入的字节数据转换为字符串(使用指定的字符集)。==
-
BufferedInputStream: 为另一个输入流提供缓冲功能,提高读取效率。
- read(), read(byte[] b), read(byte[] b, int off, int len), available(), close(): 与 FileInputStream 类似。
-
BufferedOutputStream: 为另一个输出流提供缓冲功能,提高写入效率。
- write(int b), write(byte[] b), write(byte[] b, int off, int len), flush(), close(): 与 FileOutputStream 类似。
-
ObjectInputStream: 从字节流中读取对象(反序列化)。
- ==readObject(): 读取一个对象。==
- close(): 关闭输入流。
-
ObjectOutputStream: 将对象写入字节流(序列化)。
- ==writeObject(Object obj): 写入一个对象。==
- flush(): 将缓冲区中的数据强制写入流。
- close(): 关闭输出流。
字符流:
-
FileReader: 从文件中读取字符数据.
- read(), read(char[] cbuf), read(char[] cbuf, int off, int len), close(): 与 FileInputStream 类似,但操作的是字符而不是字节。
-
FileWriter: 将字符数据写入文件.
- write(int c), write(char[] cbuf), write(char[] cbuf, int off, int len), flush(), close(): 与 FileOutputStream 类似,但操作的是字符而不是字节。
-
StringReader: 从字符串中读取字符数据.
- read(), read(char[] cbuf), read(char[] cbuf, int off, int len), close(): 与 FileReader 类似.
-
StringWriter: 将字符数据写入字符串.
- write(int c), write(char[] cbuf), write(char[] cbuf, int off, int len), flush(), close(): 与 FileWriter 类似.
- toString(): 返回写入的字符串.
-
BufferedReader: 为另一个字符输入流提供缓冲功能,提高读取效率.
- read(), read(char[] cbuf), read(char[] cbuf, int off, int len), readLine(): 读取一行文本. close(): 与 FileReader 类似,并增加了 readLine() 方法.
-
BufferedWriter: 为另一个字符输出流提供缓冲功能,提高写入效率.
- write(int c), write(char[] cbuf), write(char[] cbuf, int off, int len), newLine(): 写入一个换行符, flush(), close(): 与 FileWriter 类似,并增加了 newLine() 方法.
-
InputStreamReader: 将字节输入流转换为字符输入流,用于处理字符编码。
- read(), read(char[] cbuf), read(char[] cbuf, int off, int len), close(): 与 FileReader 类似.
-
OutputStreamWriter: 将字节输出流转换为字符输出流,用于处理字符编码.
- write(int c), write(char[] cbuf), write(char[] cbuf, int off, int len), flush(), close(): 与 FileWriter 类似.
==创建流对象的时候,系统会自动去对应位置创建对应文件,而创建输出流对象的时候,文件不存在则会报FileNotFoundException异常,也就是系统找不到指定的文件异常。==
字节流写入内存package io;
import java.io.FileInputStream;import java.io.FileNotFoundException;import java.io.IOException;
public class input2 { public static void main(String args[]){ FileInputStream inputStream = null; try { inputStream = new FileInputStream("a.txt"); int len = 0 ; // 定义字节数组,作为装字节数据的容器 byte[] bys = new byte[1024]; while ((len = inputStream.read(bys)) != -1) { // 每次读取后,把数组的有效字节部分,变成字符串打印 System.out.println(new String(bys,0,len)); }
} catch (IOException e) { e.printStackTrace(); }finally { try { inputStream.close(); } catch (IOException e) { e.printStackTrace(); } }
}}字节流写出磁盘import java.io.FileOutputStream;import java.io.IOException;
public class OutputStreamExample { public static void main(String[] args) { FileOutputStream outputStream = null; try { outputStream = new FileOutputStream("b.txt"); // 创建FileOutputStream,如果文件不存在则创建,存在则覆盖 String data = "Hello, this is byte stream output!"; // 要写入的数据 byte[] bytes = data.getBytes(); // 将字符串转换为字节数组 outputStream.write(bytes); // 将字节数组写入文件 System.out.println("数据已写入 b.txt"); } catch (IOException e) { e.printStackTrace(); } finally { try { if (outputStream != null) { outputStream.close(); // 关闭输出流,释放资源 } } catch (IOException e) { e.printStackTrace(); } } }}字符流写入内存import java.io.FileReader;import java.io.IOException;
public class FileReaderExample { public static void main(String[] args) { FileReader reader = null; try { reader = new FileReader("c.txt"); // 创建 FileReader int character; while ((character = reader.read()) != -1) { // 逐个字符读取 System.out.print((char) character); // 打印字符 } } catch (IOException e) { e.printStackTrace(); } finally { try { if (reader != null) { reader.close(); // 关闭 reader,释放资源 } } catch (IOException e) { e.printStackTrace(); } } }}字符流写出磁盘import java.io.FileWriter;import java.io.IOException;
public class FileWriterExample { public static void main(String[] args) { FileWriter writer = null; try { writer = new FileWriter("c.txt"); // 创建 FileWriter String data = "Hello, this is character stream output!"; // 要写入的数据 writer.write(data); // 将字符串写入文件 System.out.println("数据已写入 c.txt"); } catch (IOException e) { e.printStackTrace(); } finally { try { if (writer != null) { writer.close(); // 关闭writer,释放资源 } } catch (IOException e) { e.printStackTrace(); } } }}使用缓冲区import java.io.*;
public class BufferedReaderExample { public static void main(String[] args) { FileReader fileReader = null; BufferedReader bufferedReader = null;
try { fileReader = new FileReader("e.txt"); // 创建 FileReader bufferedReader = new BufferedReader(fileReader); // 使用 BufferedReader 包装 FileReader String line; while ((line = bufferedReader.readLine()) != null) { // 逐行读取 System.out.println(line); } } catch (IOException e) { e.printStackTrace(); } finally { try { if (bufferedReader != null) { bufferedReader.close(); // 关闭 BufferedReader,会自动关闭底层 FileReader } } catch (IOException e) { e.printStackTrace(); } } }}
// 写入e.txt文件import java.io.BufferedWriter;import java.io.FileWriter;import java.io.IOException;
public class BufferedWriterExample { public static void main(String[] args) {
FileWriter fileWriter = null; BufferedWriter bufferedWriter = null; try { fileWriter = new FileWriter("e.txt"); bufferedWriter = new BufferedWriter(fileWriter); bufferedWriter.write("Hello, buffered writer!"); bufferedWriter.newLine(); // 写入换行符 bufferedWriter.write("This is another line.");
} catch (IOException e) { e.printStackTrace(); } finally { try { if (bufferedWriter != null) { bufferedWriter.close(); } } catch (IOException e) { e.printStackTrace(); } } }}如果这篇文章对你有帮助,欢迎分享给更多人!
部分信息可能已经过时